MAI-Image-2.6 的提示詞:來自 Microsoft AI 的四堂課
微軟的 MAI-Image-2.6 一上榜就是 Arena 第二名。但這次發布裡更能重複使用的,是擺在旁邊的那些提示詞——四種寫法,四條你可以套到任何圖片模型上的規則。
2026 年 8 月 10 日,Microsoft AI 發表 MAI-Image-2.6,並表示它在 Arena 的文字生成圖片排行榜上排名第二,整體比 MAI-Image-2.5 高出 79 Elo,其中光是文字生成就高出 91 Elo。這是標題,而跟大多數排行榜標題一樣,它很快就會過期。
這次發布裡保存期限比較長的部分安靜得多:在 MAI-Image-2、MAI-Image-2.5 和 MAI-Image-2.6 的頁面上,微軟把範例圖背後真正的提示詞公開了出來。那些提示詞不是隨手湊的一批,而是四種明顯不同的、對圖片模型說話的方式,每一種都在做一件特定的事——描述、壓縮、編輯和引用。
MAI-Image 不在 OmniArt 的模型選單裡,所以這不是一篇你在這裡跑得到的模型評測,而是對這批提示詞手藝的解讀,因為手藝是可以搬走的。下面四種寫法在任何一個夠強的當代圖片模型上都成立,而每一堂課的形狀都一樣:你放進提示詞裡的東西,決定了你會拿到哪一種失敗。
MAI-Image 2、2.5 和 2.6 各交付了什麼#
不到五個月三次發布,每一次的重心都不一樣:
| 版本 | 發表時間 | 微軟的定位 | Arena 說法 |
|---|---|---|---|
| MAI-Image-2 | 2026 年 3 月 19 日 | 照片級寫實、畫面內文字、豐富的場景生成——「和創作者一起打造」 | 模型家族第 3 名 |
| MAI-Image-2.5 | 模型頁面 | 精準編輯、材質準確度、懂設計的輸出;Pro/標準/Flash 三種版本 | 截至 2026 年 6 月 2 日,文字生成圖片第三 |
| MAI-Image-2.6 | 2026 年 8 月 10 日 | 文字生成、人像與 3D、商業與電影感的完成度 | 文字生成圖片第二;比 2.5 高 79 Elo |
MAI-Image-2.5 還分出了一個家族:2.5-Pro 負責物件一致性和視覺推理,2.5 負責生成加上可控編輯,而 2.5-Flash 微軟形容為「以不到旗艦一半的價格達到可上線的程度」。2.5 的模型頁面畫的是「Image Arena Elo 對每千張圖的代表性 API 價格」,這就告訴你團隊在優化什麼:不只是巔峰畫質,而是每一塊錢買到的畫質。
至於 2.6,微軟說還有些東西尚未細講——「從跨多份參考素材運作、更豐富的定位,到對推理、格式和解析度更強的控制」。在那些真的公開之前,那是路線圖聲明,不是規格。
第一課:長的結構化提示詞,讓每個事實各佔一格#
MAI-Image-2.5 頁面上那張照片級寫實範例背後的提示詞大約 90 個字,而它的結構比長度更有意思:
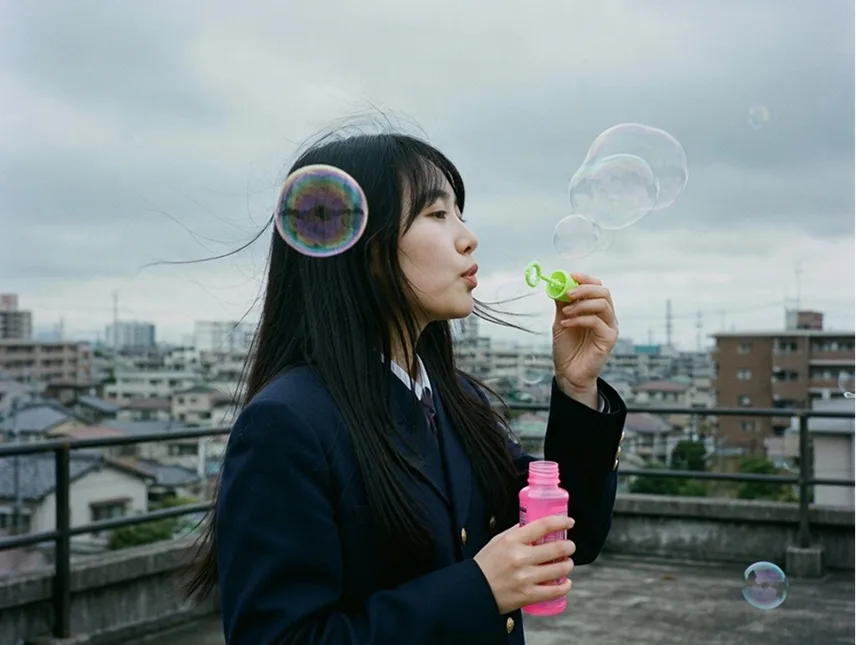
再讀一次,但把它當成一種格式,而不是一段句子。第一句是主體、姿勢、動作和天空。第二句是頭髮和服裝。第三句是道具,一手一個。第四句是一個可數的元素。接著一個帶標籤的區塊——Behind her:——把所有環境資訊收進去,最後用兩個字的風格指令收尾。
這個結構裡有三件事真的在做工:
- 用指名的顏色,而不是形容詞。 「Hot pink」、「neon lime-green」、「dark navy」、「gold」、「flat gray」。不是「明亮」,不是「多彩」。一個顏色名字是模型可以滿足、也可以明顯失敗的約束;「鮮豔」不是。
- 用數字,而不是量詞。 「Five iridescent bubbles of varying sizes」是查得了的。「一些泡泡」不是。在公開的成品裡數量守住了——你可以站在圖前面一顆一顆數,這正是重點。
- 背景有自己的容器。
Behind her:把環境圍起來,讓它的細節沒辦法滲進主體描述。長提示詞失敗,通常就是因為模型得猜某個修飾語到底屬於哪個名詞。
風格關鍵詞放在最後,排在內容之後,所以它修飾的是一個已經完全指定好的場景,而不是反過來去帶動構圖。
小技巧
長提示詞要當成一格一格的欄位來寫,不要當成散文:主體與動作,然後外觀,然後道具,然後可數的細節,然後一個帶標籤的環境區塊,最後才是風格。如果你指不出某個字屬於哪一格,模型也指不出來。
第二課:短提示詞用一個比喻把構圖買下來#
MAI-Image-2 的發布公告貼出了一條非常不一樣的提示詞——大約 30 個字,沒有完整句子,只有排好序的短語:
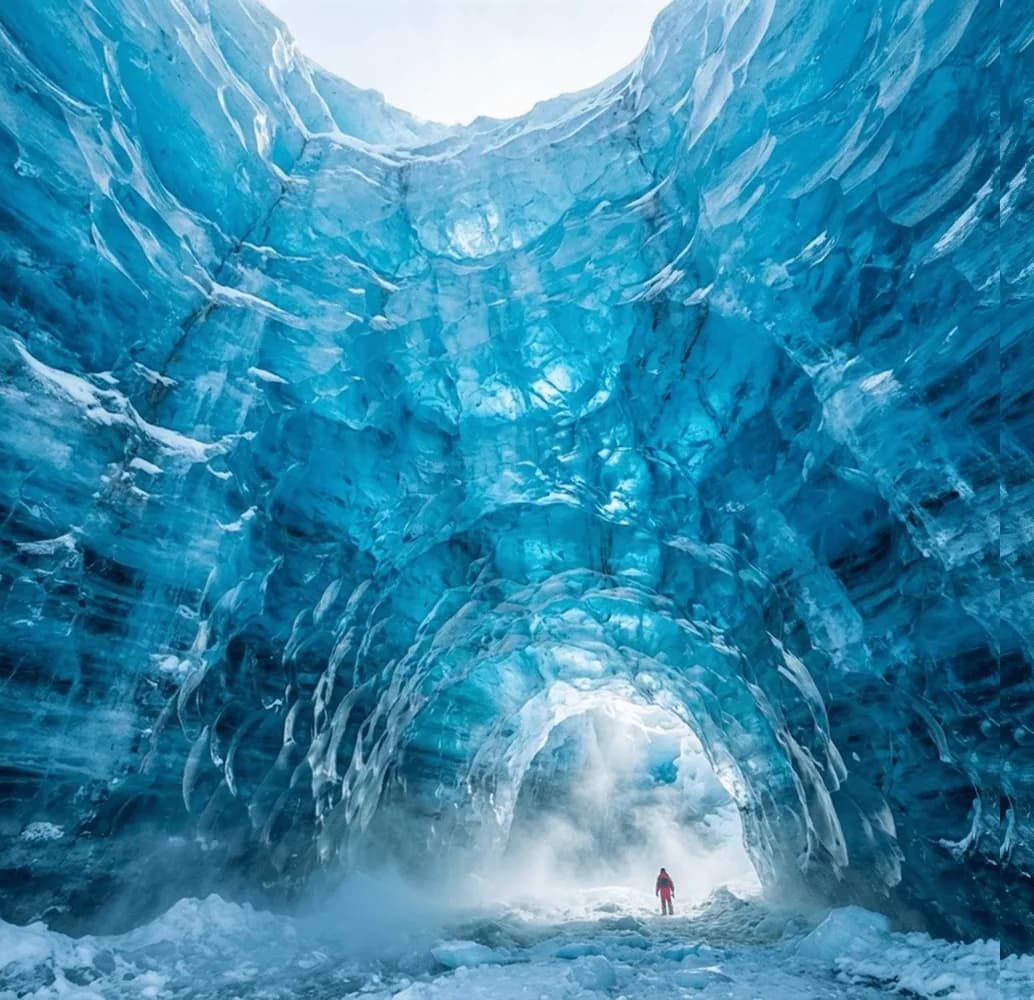
第一個短語就是整個訣竅。「Like a cathedral interior」不是裝飾,而是一條偽裝成隱喻的構圖指令。一座教堂帶來拱頂天花板、往後退去的中殿、拱門、對稱,以及從遠端射進來的光。成品五樣都有,只是用冰做的。要把那個版面直白地寫出來,得花三十個字,而且大概還更僵硬。
第二個好用的招數是 tiny human figure at base for scale。尺度是圖片模型最容易搞丟的東西,因為紋理本身不會告訴你它有多大。一個被指名的人形參考放在一個被指名的位置,四個字就把它釘住了;而成品裡那件紅外套做的構圖工作,比任何「史詩、巨大、宏偉」都多。
尾巴上那幾個詞——cinematic、cold mist in air、hyper-real detail——是氛圍和算繪指令,放在最後的理由,和第一課裡風格關鍵詞放最後是同一個。
所以這兩條提示詞不是彼此的好版本和壞版本,而是不同的工具:
| 什麼時候用長的結構化提示詞 | 什麼時候用短的堆疊式提示詞 |
|---|---|
| 服裝、道具或品牌細節很要緊 | 你想要一張夠強的圖,之後再迭代 |
| 有人會拿成品去對 brief | 氛圍比清單更重要 |
| 你之後需要重現它 | 你在探索一種風格 |
| 數量和顏色沒有商量餘地 | 一個好的比喻就撐得起構圖 |
第三課:在編輯裡,一條提示詞只做一個改動#
MAI-Image-2.5 的頁面用三條提示詞示範編輯,而最醒目的是每一條都非常小:
這是第一條的前後對照:
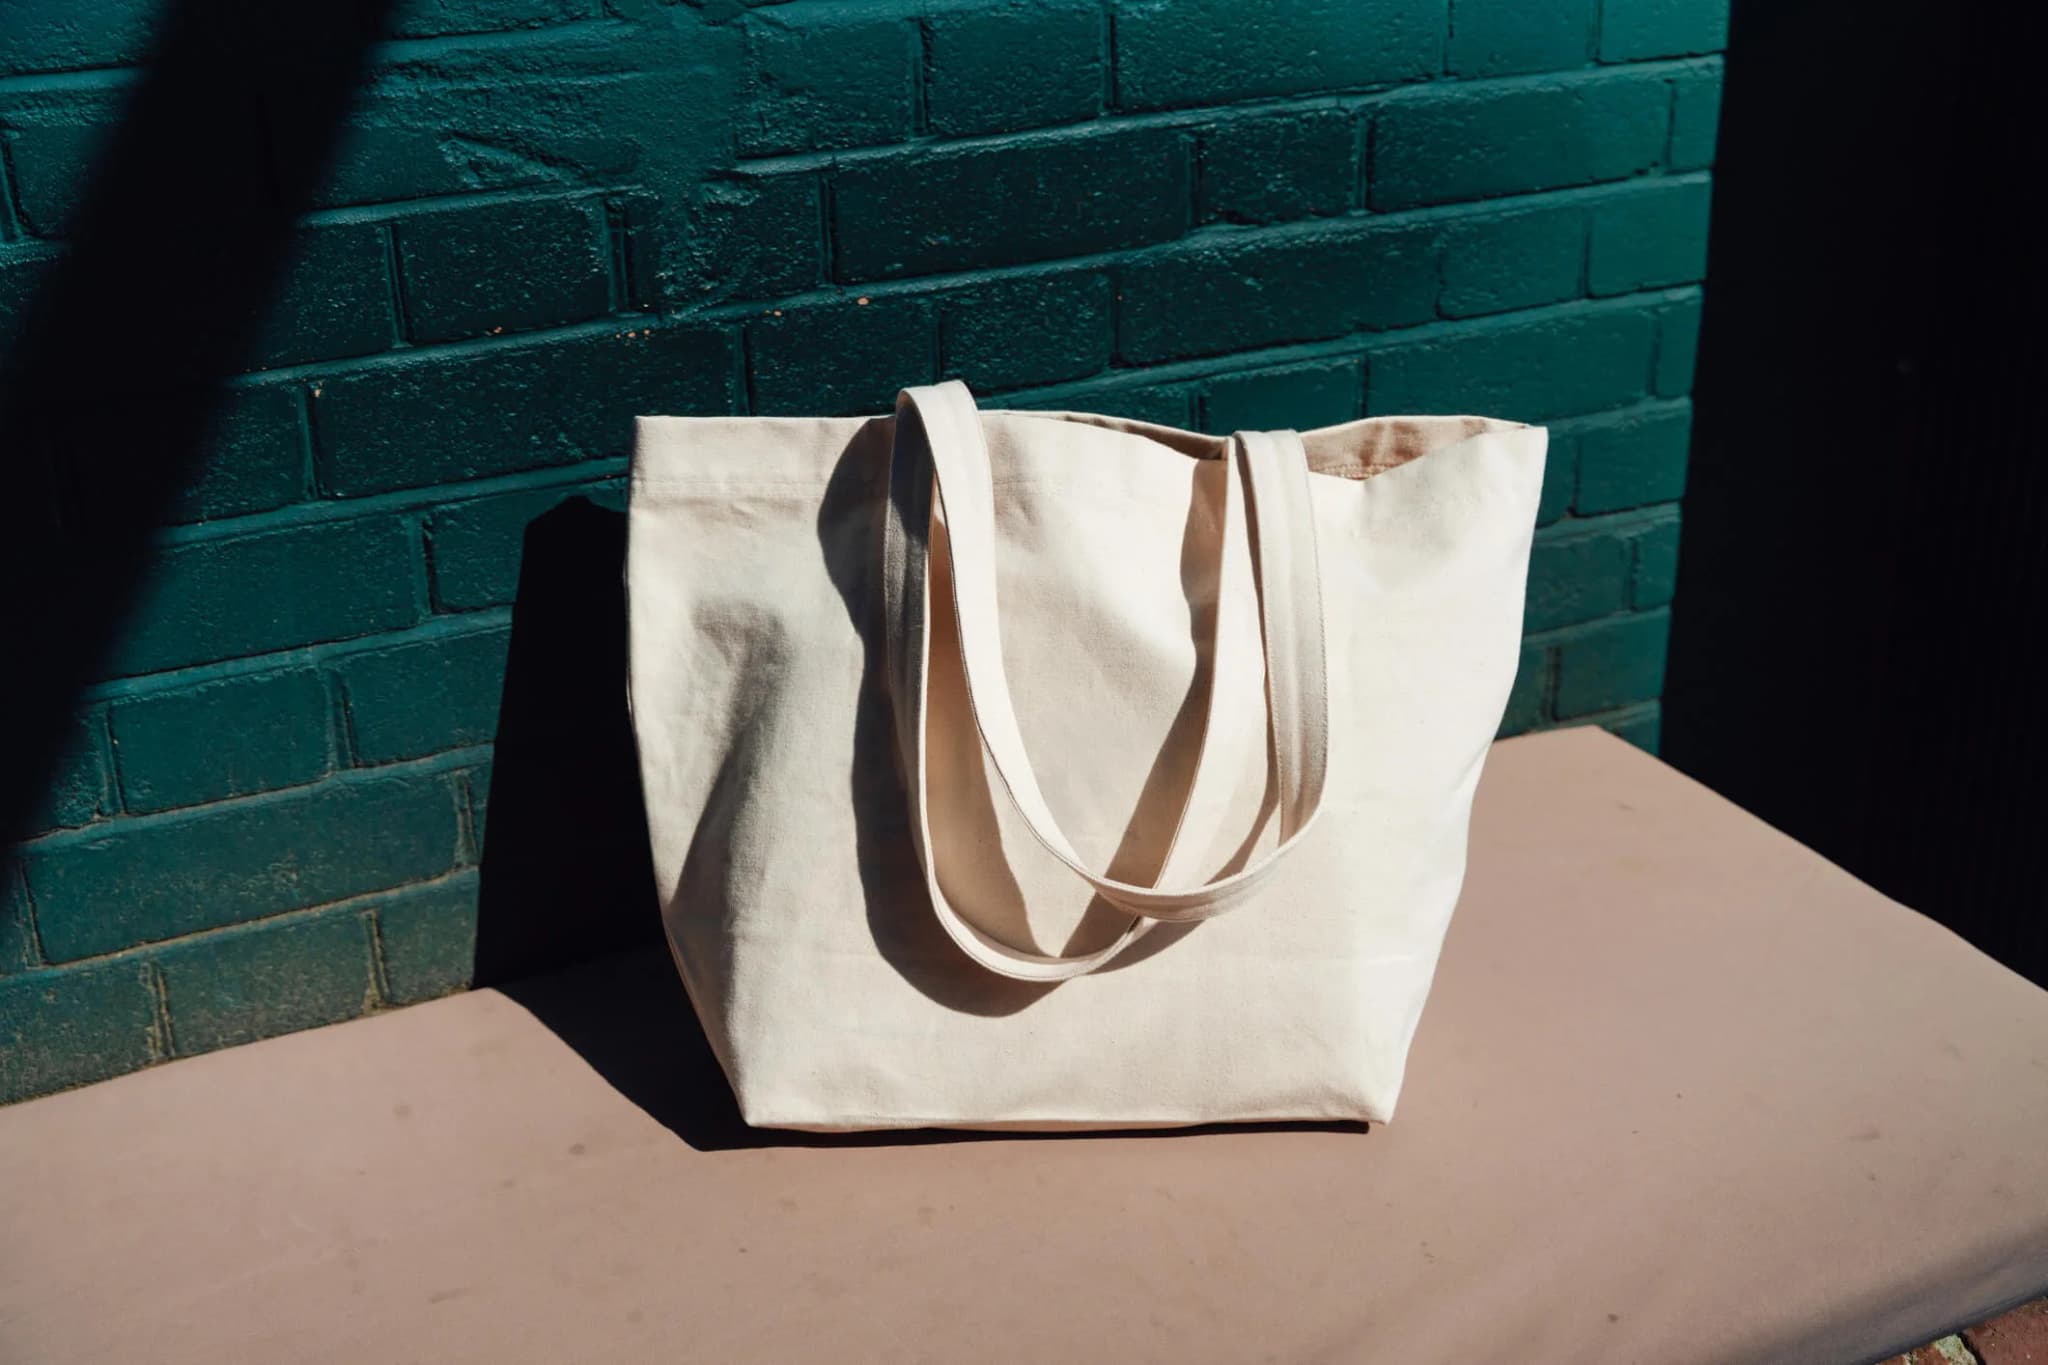
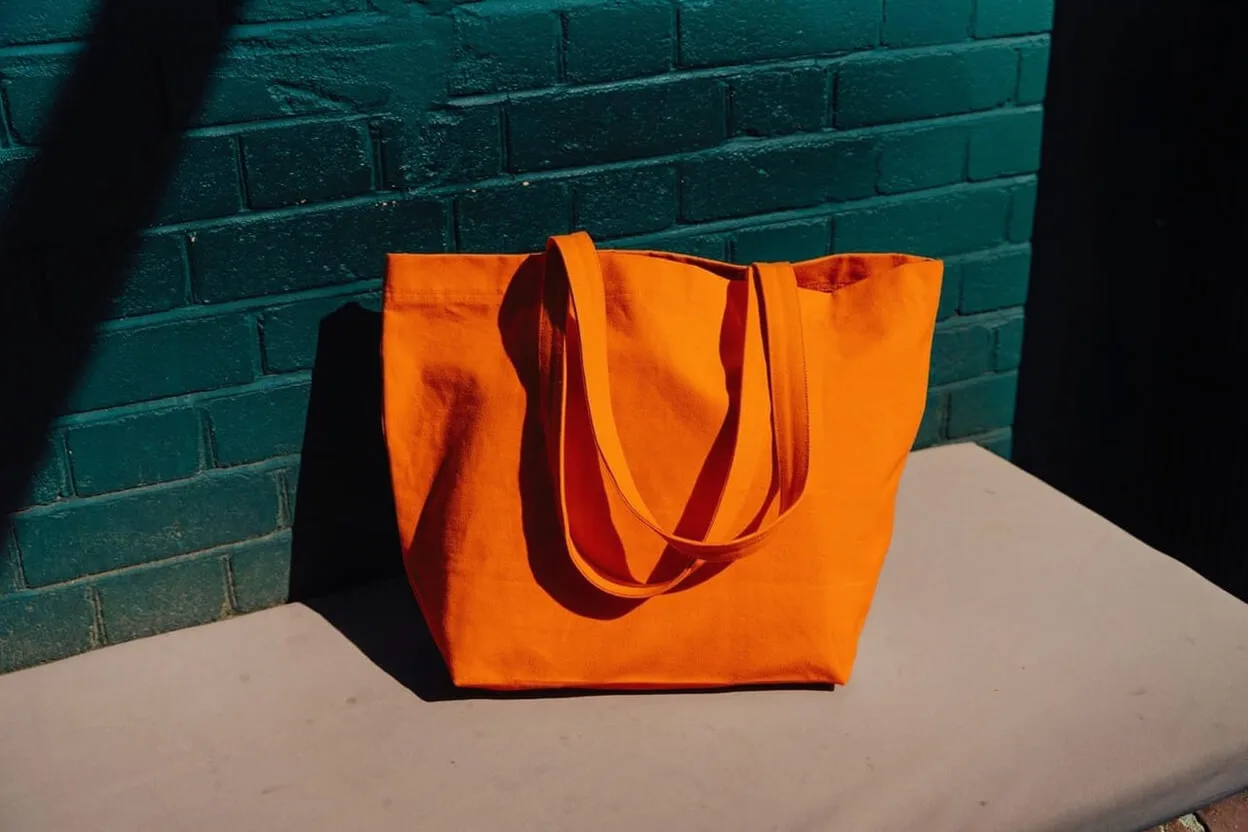
這條提示詞只有六個字:一個動詞、一個指名的物件、一個目標值。它沒有順便要求換背景、換角度,或把光線弄好。這種克制就是技術本身,因為在一次編輯裡,模型最難的工作是保留,不是改變。 你在指令裡多加的每一樣東西,都是它可能決定重做的另一樣東西。
也注意那個物件是被指名的。「The tote」給了模型一個毫不含糊的指涉對象。「把它變成橘色」則會讓模型在包、桌子和牆之間自己選。
第三條提示詞——把主體搬到紐約——看起來是大得多的操作,確實也是。但它仍然是一個操作,而且仍然指名了必須保留的東西:「the woman」。一條同時還改了她的穿搭、換了時段的搬遷提示詞,會讓你完全無從判斷是哪一條指令造成了糟糕的結果。
注意
一連串小編輯,也是一連串小漂移。每一步之後都重新檢查你在意的細節,不要只在最後才檢查——膚色、標誌的幾何和文字,是連跑幾趟時最先悄悄劣化的東西。
第四課:文化引用很便宜,而且它只買得到場景#
公開的提示詞裡最短的一條只有八個字:
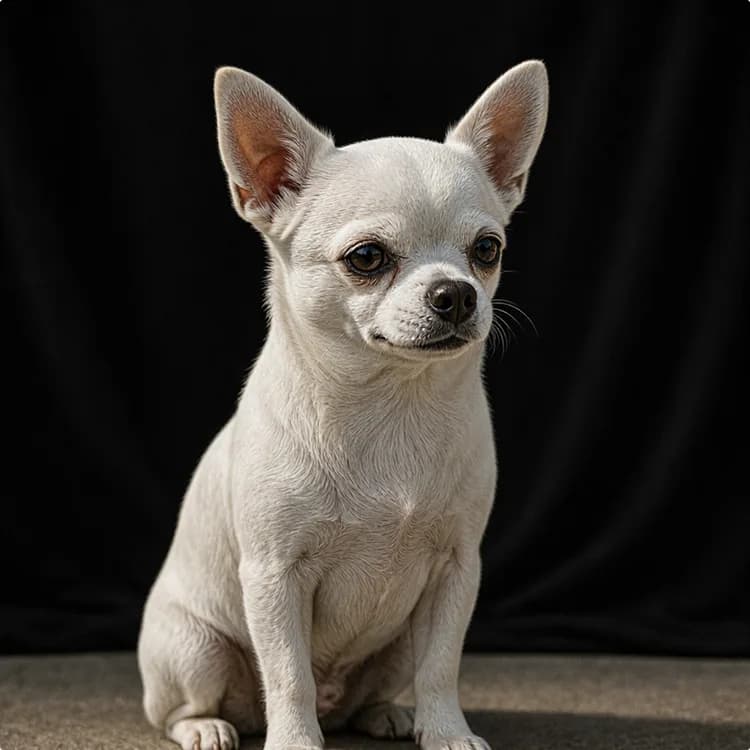
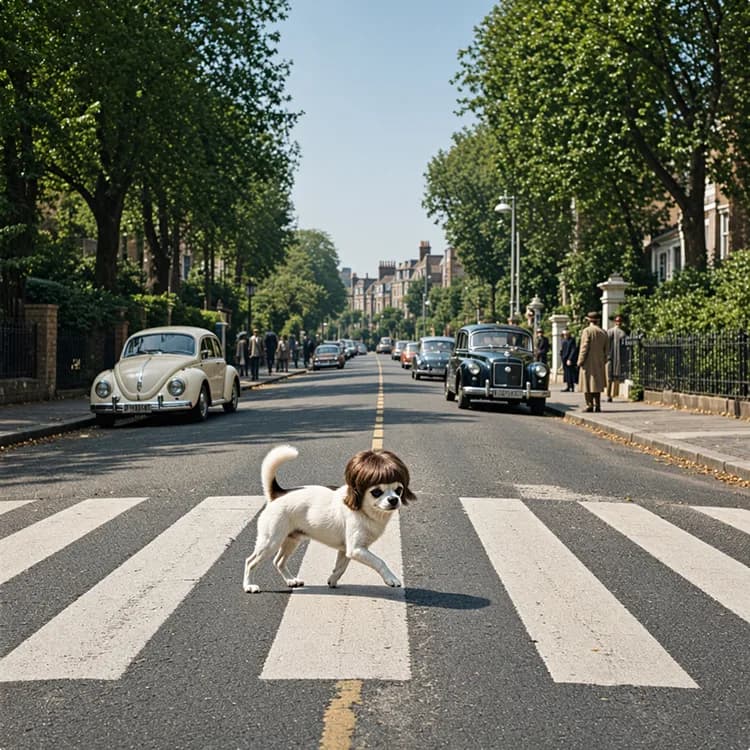
八個字重建了一個非常具體的場景:斑馬線、往後退去的林蔭道路、停在左邊的白色 VW 金龜車、年代感的車輛、穿六〇年代大衣的行人,還有那個平正的正面取景。要把這些一字一句寫出來,得花一整段,而且大概還是會漏掉金龜車。微軟把這件事歸在「世界知識與推理」底下,這個框架是對的——一個廣為人知的引用,是你能拿到最壓縮的提示詞單位。
它同時也是最不可控的,而這個例子正好指出了界線在哪裡。比較兩張圖:原圖是一隻米色短毛、耳朵大而豎立的吉娃娃,背景全黑。成品是一隻白棕相間的狗,毛不一樣、比例不一樣、耳朵也不一樣。那個引用買到了場景,卻沒有保住主體。
這個區別就是實務上的收穫。引用式的速記非常適合建立一個世界——一個類型、一個年代、一套打光慣例、一種版面。它對識別則不可靠。如果某張臉、某隻寵物、某個產品或某個包裝一定要活下來,那個需求就該寫在明確的描述裡,或走參考素材的流程,而不是託付給一個文化典故。
還有兩個要放在心上的但書:引用只有在模型認得它的時候才有效,所以冷僻或地域性的引用會無聲地退化成通用畫面;而知名影像帶著權利問題,那不是一條提示詞替你解決得了的。
為什麼文字生成變成了那個標題數字#
2.6 發布裡的所有東西之中,微軟選擇單獨拉出來講的是文字:+91 Elo,高於整體的 +79 Elo。這是刻意的強調,而範例作品說明了原因。
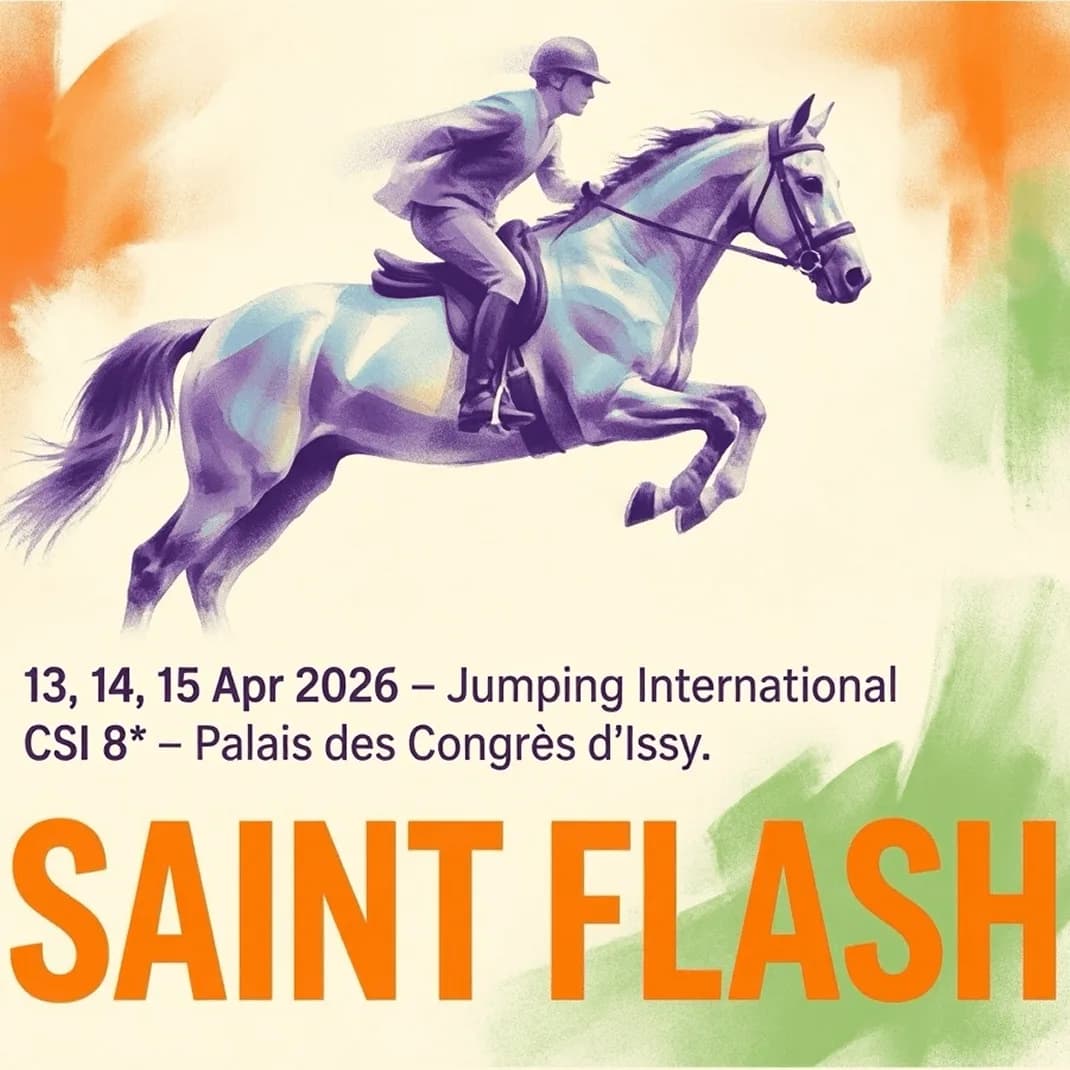
把標題拼對只是簡單的那一半。上面那張海報還撐住了一個帶重音的法文地名、一個評級裡的星號、一串用逗號分隔的日期,而最重要的是一套層級:日期行從屬,標題主導,插畫拿到上面三分之二。一個拼字完美、卻把每一塊文字都給同樣分量的模型,做出來的版面照樣不能用。
這是圖片生成裡最貼近付費工作的部分,也是為什麼 2.5 頁面上的合作夥伴引言都圍著它打轉。WPP 的全球創意長 Rob Reilly 把文字準確度和自然語言編輯並列,稱它是「真正的突破」;Shutterstock 的 Vanessa Salvo 則把關鍵指標定義成模型能不能「把意圖轉換成一致、可上線的成品」。包裝、海報、菜單和行銷素材,全都是先敗在排版,才敗在照片級寫實。
「Arena 第二名」告訴你什麼、又沒告訴你什麼#
Arena 的結果是盲測的人類偏好比較,所以一次大幅的 Elo 跳升,確實是「人們在一組混合提示詞上比較喜歡這些成品」的真實訊號。這是貨真價實的結果,而大約兩個月內漲 79 Elo 也爬得很快。
它同時也只是一個彙總數字。微軟的公告沒有公布各類別的 Elo 值、信賴區間、提示詞集的規模,也沒有說排在它上面的是哪個模型。截至 2026 年 8 月 14 日,一個團隊在把流程押上去之前需要的幾件事,都還沒公開:
- 2.6 級距的每張圖 API 價格
- 原生和最大輸出解析度
- 生成與編輯的延遲數字
- 被形容為「即將推出」的多參考素材和定位能力
- 那些 Elo 差距背後的技術報告
說明
一個整體的 Arena 排名,沒辦法告訴你這個模型適不適合你這件事。非拉丁文字的重文字包裝、一張必須在十二顆鏡頭裡重複出現的臉,以及一份給遊戲介面用的透明素材,是三種不同的測驗;一個模型可以在彙總上領先,卻在其中任何一項上落敗。
對 2.6 誠實的解讀是窄的,但依然有用:微軟把這個家族迭代得很快,而且把進步瞄準了商業成品——文字、人像、產品、品牌——而不是奇觀。
在 OmniArt 上跑這四種寫法#
MAI-Image 目前不在 OmniArt 的圖片工作台裡。那些提示詞寫法在,而且它們不挑模型。照你的 brief 實際上屬於四件工作中的哪一件來挑:
| 寫法 | 用在哪裡 | OmniArt 上實際的起點 |
|---|---|---|
| 長的結構化提示詞 | 服裝、道具、顏色和數量會被檢查的 brief | GPT Image 2 |
| 帶比喻的短堆疊提示詞 | 有電影感的單張圖片和氛圍探索 | Seedream 5.0 Pro |
| 一次只改一件事的編輯 | 產品配色、加東西、受控的場景搬遷 | Nano Banana 2 |
| 引用式速記加上明確的識別 | 主體必須保持一致的場景建構 | Seedream 5.0 Pro 搭配參考素材 |
| 定案前的便宜迭代 | 用低成本測試提示詞結構 | Qwen Image |
一個很有用的練習:把上面那條頂樓提示詞原封不動跑一次,然後再跑一次,這次把顏色換成形容詞(「一個粉紅色瓶子」、「一支綠色吹棒」),把數量換成「一些泡泡」。這兩份成品之間的落差,就是結構的價值——而且是在你自己的模型上量出來的,不是在發表會的展示圖裡。
想看版面和照片級寫實的當代對決,請看 GPT Image 2 對比 Nano Banana 2。想做參考素材驅動的一致性,Seedream 5.0 Pro 發表指南講了它的輸入和控制項,而 Qwen Image 指南則是早期草稿的低成本路線。想讀一次可比較的近期發表,Grok Imagine Image 2.0 在同一週提出了類似的 Arena 說法。
常見問題#
MAI-Image-2.6 是什麼?
MAI-Image-2.6 是 Microsoft AI 在 2026 年 8 月 10 日發表的文字生成圖片模型。微軟表示它在 Arena 的文字生成圖片排行榜上排名第二,比 MAI-Image-2.5 高出 79 Elo,其中文字生成提升 91 Elo。
MAI-Image-2.6 和 MAI-Image-2.5 差在哪裡?
微軟形容它在每一個被量測的 Arena 類別上都有進步,並特別強調文字生成、人像與 3D 影像,以及在產品、品牌和電影感工作上更加打磨過的商業與寫實成品。多參考素材輸入、更豐富的定位,以及對推理、格式和解析度更強的控制,都被描述為即將推出,但沒有公開細節。
我可以在哪裡用 MAI-Image-2.6?
微軟的公告說它可以在 Arena 上做文字生成圖片,該週稍後會登上 MAI Playground,並陸續在 Microsoft Foundry 和其他產品上推出。
OmniArt 上有 MAI-Image 嗎?
沒有。MAI-Image 不在 OmniArt 的圖片模型選單裡。這篇文章裡的提示詞寫法不挑模型,可以在 OmniArt 提供的圖片模型上跑。
MAI-Image-2.5 這個模型家族是什麼?
三個版本:MAI-Image-2.5-Pro 負責物件一致性和視覺推理,MAI-Image-2.5 負責高品質生成加上可控編輯,而 MAI-Image-2.5-Flash 被形容為以不到旗艦一半的價格達到可上線的程度。
這些提示詞寫法在別的圖片模型上也管用嗎?
管用。指名的顏色、明確的數量、圍起來的背景區塊、一個尺度錨點、一次只改一件事,以及一個構圖用的比喻,全都是通用的提示詞技巧。模型之間的差別在於每一項被遵守得多可靠,那值得在你真正在用的模型上測一測。
在 OmniArt 上開始#
打開 OmniArt 的圖片工作台,拿同一份 brief 跑上面四種寫法中的兩種——同一個想法的長結構版和短堆疊版。主體保持完全一致,只改提示詞的形式。光是這一次比較,就會比任何排行榜名次更能告訴你自己的模型是什麼樣子。
從那裡開始,把編輯當成另一件事來做:先定案一張圖,然後一條提示詞只做一個改動,每跑完一趟就檢查你在意的細節。OmniArt 把圖片、影片、音訊和音樂模型放在同一個工作台,所以一張定案的靜態圖可以直接進到動態,不用換工具——而當一個新模型憑本事進到選單時,你已經學會怎麼寫的那些提示詞,也會跟著你一起過去。