MAI-Image-2.6
微软的 MAI-Image-2.6 登上 Arena 第二。这次发布里更值得复用的,其实是随之公开的那几条提示词——四种写法,四条能迁移到任何模型的规则。
2026 年 8 月 10 日,微软 AI 发布 MAI-Image-2.6,并称其在 Arena 文生图榜单上排名第二,整体较 MAI-Image-2.5 提升 +79 Elo,其中文字渲染单项提升 +91 Elo。这是标题,而榜单标题通常过期得很快。
这次发布里保质期更长的部分要安静得多:在 MAI-Image-2、MAI-Image-2.5 和 MAI-Image-2.6 三个页面上,微软把样例图背后的提示词原文一并公开了。这些提示词不是随手凑的一组,它们代表四种截然不同的写法,各自在做一件具体的事——描述、压缩、编辑、引用。
OmniArt 的模型列表里没有 MAI-Image,所以这不是一篇你能在这里跑起来的模型评测。它读的是这些提示词展示出的写法,因为写法是可以迁移的。下面四种模式在任何一款当前的成熟图片模型上都成立,而每一条的结论形状都一样:你在提示词里放了什么,决定了你会拿到哪一种失败。
MAI-Image 2、2.5 与 2.6 分别交付了什么#
不到五个月三次发布,每次的重心都不同:
| 版本 | 发布时间 | 微软的定位 | Arena 说法 |
|---|---|---|---|
| MAI-Image-2 | 2026 年 3 月 19 日 | 写实、图内文字、复杂场景生成——"与创作者一起打造" | 模型家族第三 |
| MAI-Image-2.5 | 模型页 | 精确编辑、材质准确度、面向设计的输出;Pro / 标准 / Flash 三档 | 文生图第三,截至 2026 年 6 月 2 日 |
| MAI-Image-2.6 | 2026 年 8 月 10 日 | 文字渲染、人像与 3D、商业与电影感的完成度 | 文生图第二;较 2.5 提升 +79 Elo |
MAI-Image-2.5 同时拆成了一个家族:2.5-Pro 主打物体一致性与视觉推理,2.5 兼顾生成与可控编辑,2.5-Flash 则被微软描述为价格不到旗舰一半、可直接投产。2.5 的模型页上有一张"Image Arena Elo 对每千张图代表性 API 价格"的图表,这说明了团队在优化什么:不是单纯的画质峰值,而是每一块钱换来的画质。
关于 2.6,微软说还有一些尚未展开的内容——"从跨多个参考图工作、更丰富的接地,到对推理、格式和分辨率的更强控制"。在这些公开落地之前,它们是路线图表述,不是规格。
经验一:长结构化提示词,让每个事实各就各位#
MAI-Image-2.5 页面上写实样例背后的提示词大约 90 个词,它的结构比长度更值得看:
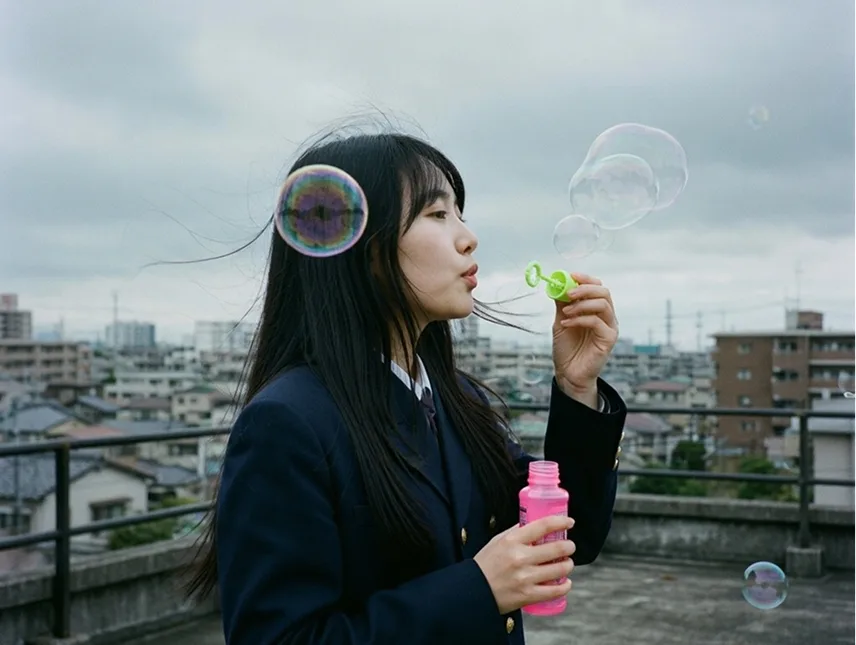
把它当成一种格式而不是一段话再读一遍。第一句是主体、姿态、动作和天空。第二句是发型与服装。第三句是道具,一只手一件。第四句是可数元素。接着一个带标签的区块——Behind her:——收走所有环境信息,最后两个词的风格指令收尾。
这个结构里有三件事在真正起作用:
- 用颜色名,而不是形容词。"hot pink""neon lime-green""dark navy""gold""flat gray"。不是"鲜艳",也不是"色彩丰富"。颜色名是模型能满足、也能被肉眼判定失败的约束;"vibrant"不是。
- 用数字,而不是量的模糊说法。"Five iridescent bubbles of varying sizes"是可核对的,"some bubbles"不是。在公开的成图里这个数量确实成立——你可以站在图前一个个数,而这正是重点。
- 背景装进自己的容器。
Behind her:把环境圈了起来,它的细节就没法渗进主体描述。长提示词失效,往往是因为模型得猜某个修饰语属于哪个名词。
风格关键词放在最后,落在一个已经被完整指定的场景上,而不是反过来去左右构图。
提示
把长提示词写成一个个格位,而不是散文:主体与动作、外观、道具、可数细节、带标签的环境区块、风格。如果你自己都指不出某个词属于哪个格位,模型同样指不出来。
经验二:短提示词用一个比喻买下构图#
MAI-Image-2 的发布公告公开了一条很不一样的提示词——约 30 个词,没有完整句子,只有按重要性排开的短语:
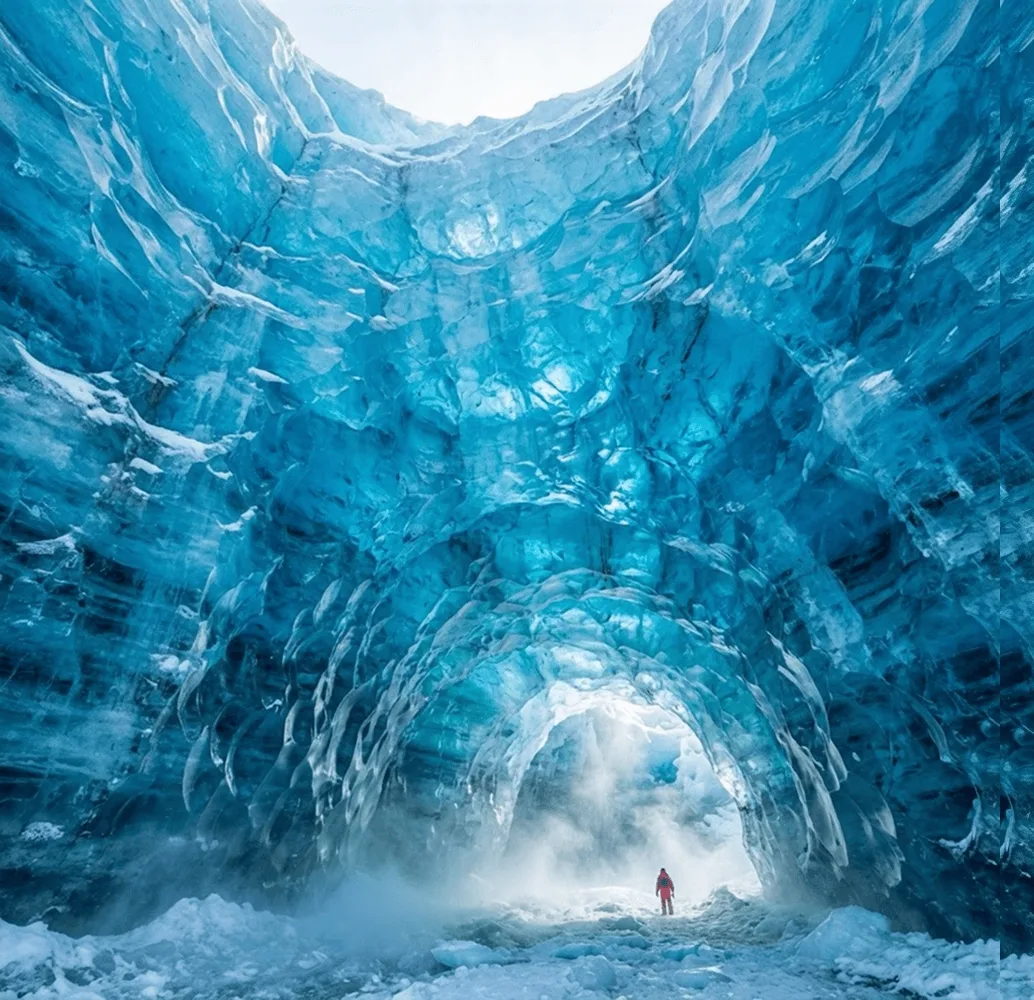
第一个短语就是全部的诀窍。"like a cathedral interior"不是修饰,而是伪装成比喻的构图指令。教堂自带拱顶、纵深的中殿、拱门、对称,以及从尽头进来的光。成图上这五样都在,只不过是用冰做的。把这套布局直白写出来要三十个词,而且多半更僵硬。
第二个有用的动作是 tiny human figure at base for scale。尺度是图片模型最容易丢的东西,因为材质本身不告诉你它有多大。一个位置明确的人体参照用四个词就把它钉住了,成图里那件红外套所做的构图工作,比堆多少"epic, massive, enormous"都多。
结尾那几个词——cinematic、cold mist in air、hyper-real detail——是氛围和渲染指令,放在最后的理由和经验一里的风格关键词一样。
所以这两条提示词不是同一件事的好版本和差版本,它们是不同的工具:
| 用长结构化提示词,当 | 用短堆叠提示词,当 |
|---|---|
| 服装、道具或品牌细节必须准确 | 你只要一张够强的图,然后再迭代 |
| 有人会拿成图去对需求单 | 氛围比清单更重要 |
| 你之后需要复现它 | 你在探索一种调性 |
| 数量和颜色没有商量余地 | 一个好比喻足以撑起构图 |
经验三:做编辑时,一条提示词只改一件事#
MAI-Image-2.5 页面用三条提示词演示编辑,最值得注意的是每条都很小:
下面是第一条的改前与改后:
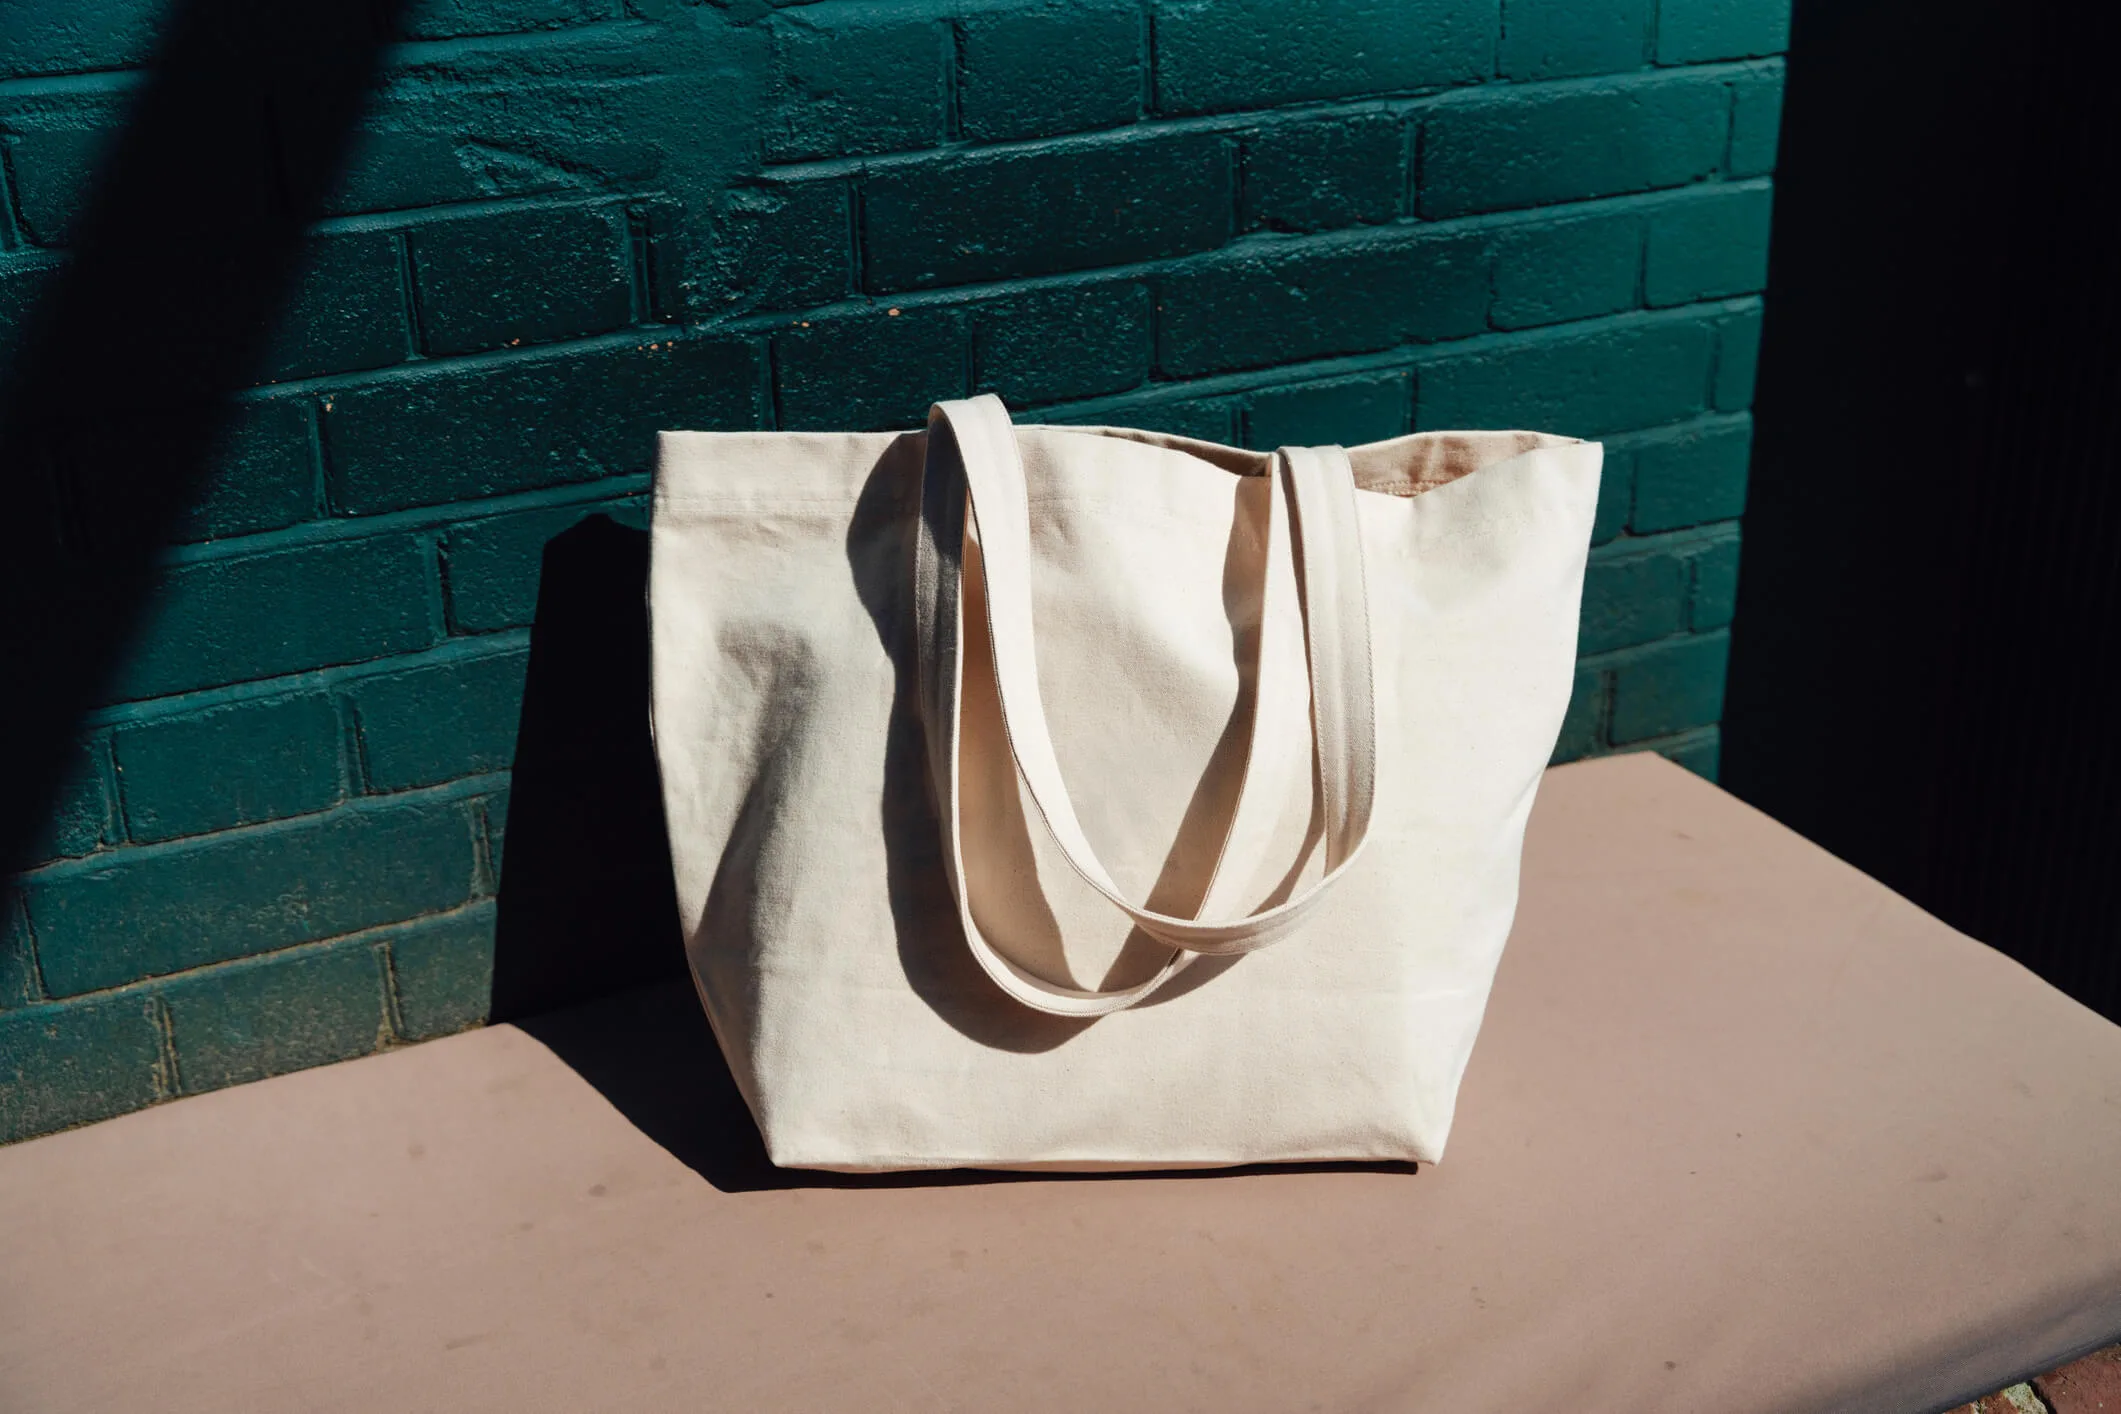
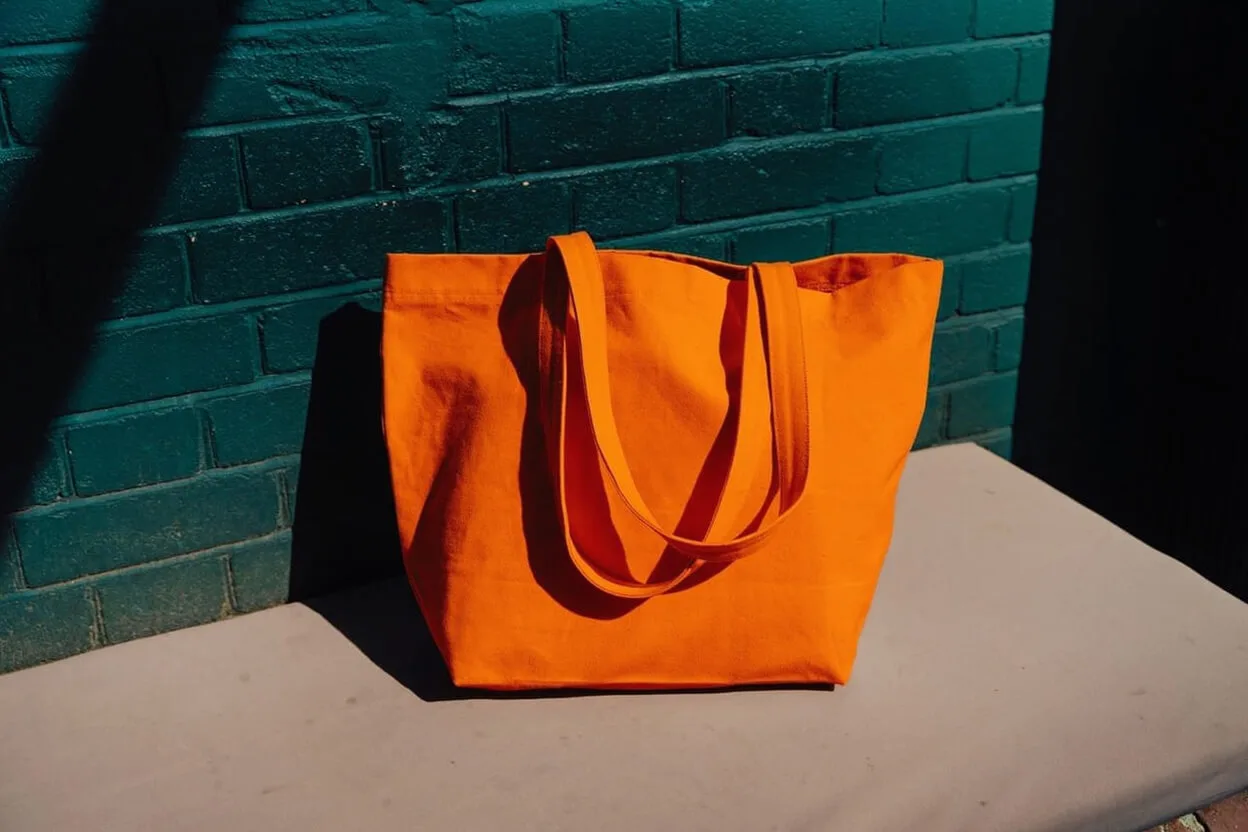
这条提示词只有六个词:一个动词、一个被点名的物体、一个目标值。它没有顺带要求换背景、换角度或者改善打光。这种克制就是技巧本身,因为在一次编辑里,模型最难的活是保留,不是改动。你往指令里多加一样,就多给它一个重做的机会。
还要注意物体是被点名的。"the tote"给了模型一个没有歧义的指代对象。"把它改成橙色"则让模型在包、桌子和墙之间自己挑。
第三条提示词——把人物挪到纽约——看起来是大得多的操作,确实如此。但它仍然是一次操作,而且仍然点名了必须延续的东西:"the woman"。一条既换城市、又改造型、又调时间的提示词,会让你完全无法判断是哪句指令导致了坏结果。
警告
一串小编辑同时也是一串小漂移。你在意的细节要在每一步之后复查,而不是只在最后看一次——肤色、logo 的几何形状和文字,是多轮之后最先悄悄劣化的三样。
经验四:文化引用很便宜,但它只买得到场景#
公开提示词里最短的一条只有八个词:
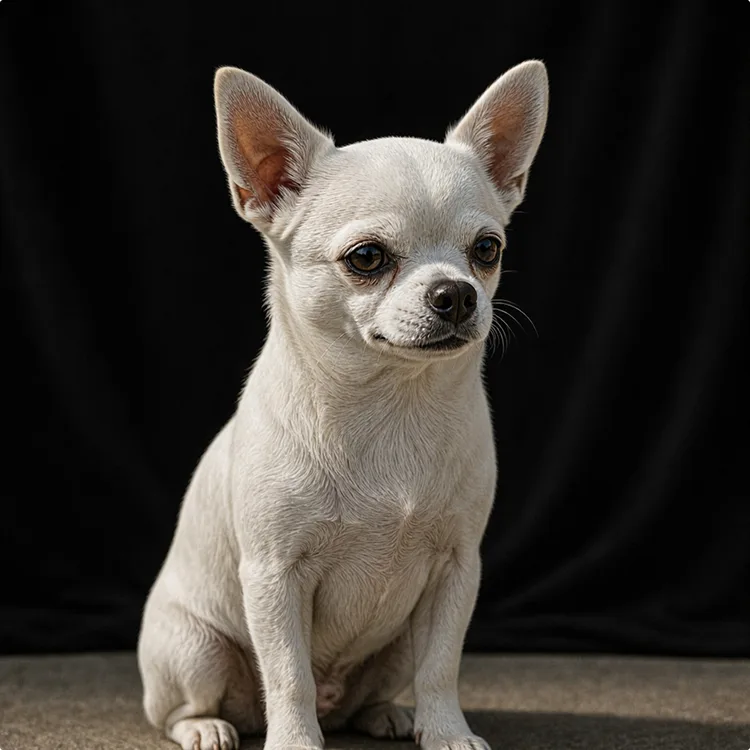
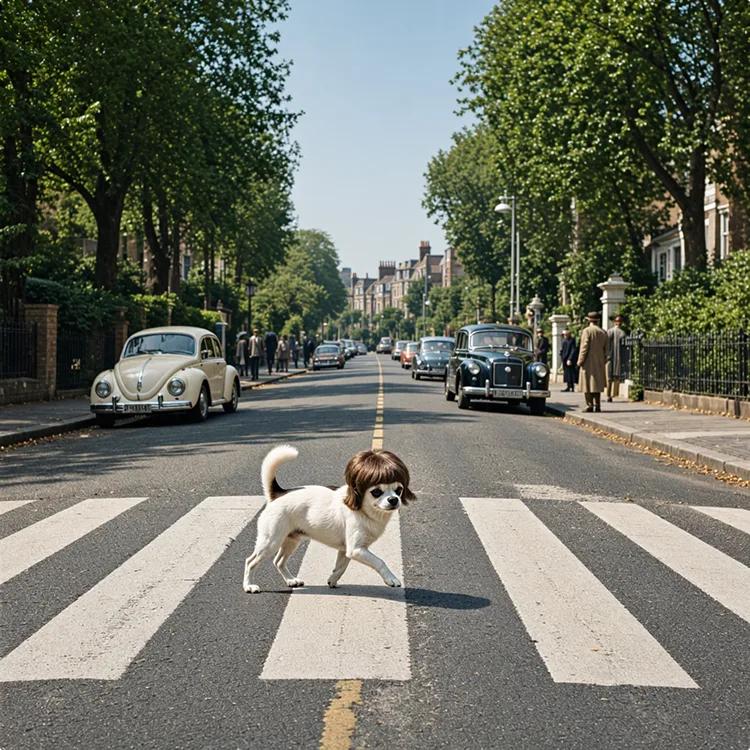
八个词重建了一个非常具体的场景:斑马线、向远处收缩的林荫道、停在左边的白色甲壳虫、老式汽车、穿六十年代大衣的行人,以及平视正面的取景。把这些一条条写出来要一整段,而且多半还会漏掉那辆甲壳虫。微软把这一项归在"世界知识与推理"下,这个归类是对的——一个足够知名的引用,是可用的最压缩的提示词。
它同时也是最不可控的,而这个例子恰好显示出边界在哪里。对比两张图:原图是纯黑背景前一只米白色短毛、竖耳的吉娃娃;成图是一只白棕相间、毛质不同、比例不同、耳朵也不同的狗。引用买到了场景,没有保住主体。
这个区分才是可操作的结论。引用式速写非常适合立起一个世界——一种类型、一个年代、一套打光惯例、一种版式。它在身份一致性上并不可靠。如果某张脸、某只宠物、某件产品或某个包装必须延续下去,这个要求该写进显式描述或参考图流程,而不是托付给一个文化典故。
还有两点值得记住:引用只在模型认得它时才有效,冷门或地域性的引用会无声地退化成泛泛的结果;而知名影像本身带有权利问题,提示词并不能替你解决。
文字渲染为什么成了那个头条数字#
2.6 公告里的所有内容中,微软单独拎出来的数字是文字:+91 Elo,高于 +79 Elo 的整体增幅。这是刻意的强调,样例作品解释了原因。
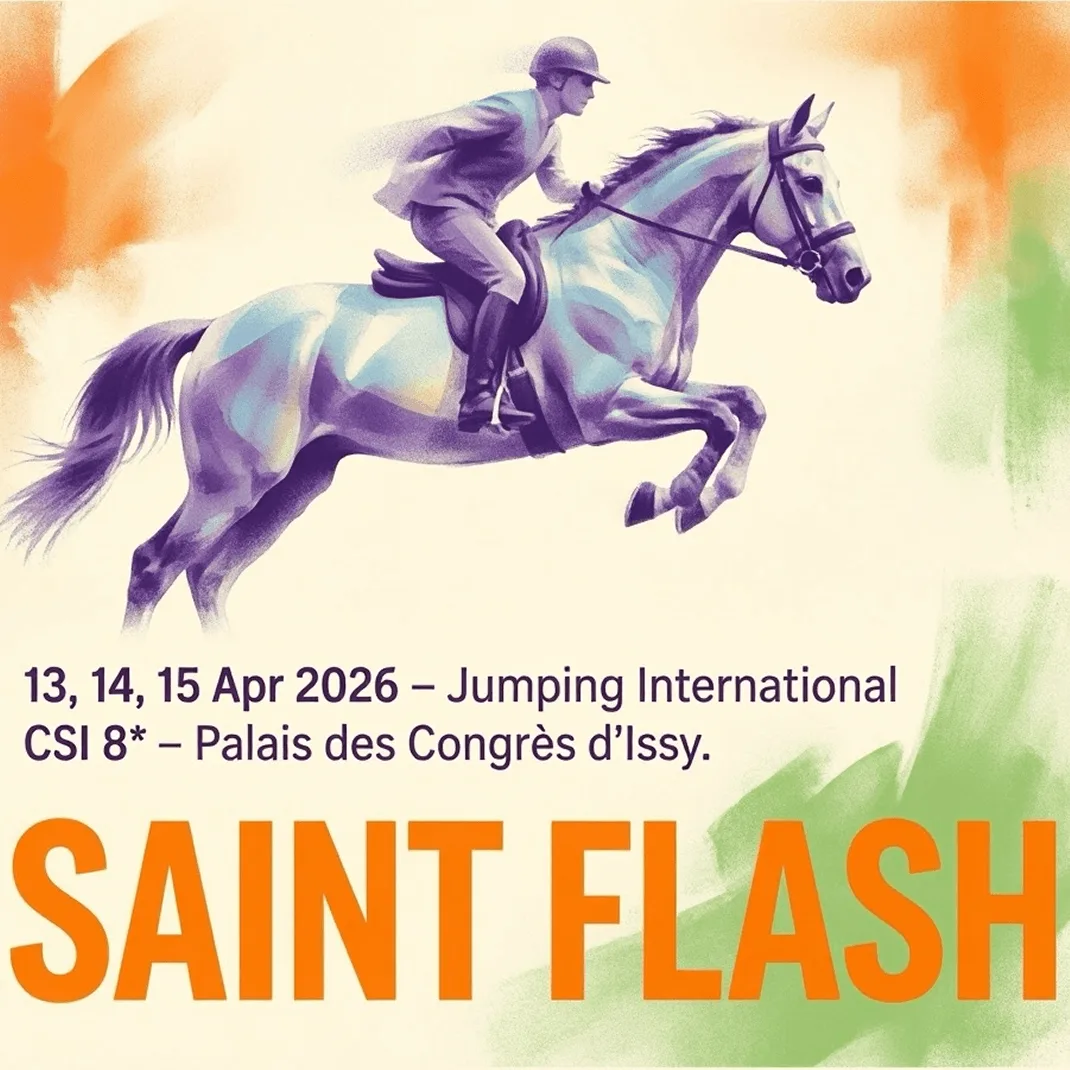
把标题拼对只是容易的那一半。上面这张海报还稳住了一个带音符的法语地名、一个评级里的星号、一串逗号分隔的日期,以及最重要的——层级:日期行退居次要,主标题占据主导,插画拿走上方三分之二。一个拼写完美却把每块文字都给同样视觉重量的模型,产出的仍然是没法用的版面。
这是图片生成里最贴近付费工作的部分,也是 2.5 页面上合作方证言集中在这里的原因。WPP 全球首席创意官 Rob Reilly 把文字准确度和自然语言编辑一起点名为"真正的突破";Shutterstock 的 Vanessa Salvo 则把关键指标定义为模型能否"把意图转化为稳定的、可投产的输出"。包装、海报、菜单和 campaign 素材,都是先败在排版上,而不是先败在写实度上。
"Arena 第二"说明了什么,又没说明什么#
Arena 结果是盲测的人类偏好对比,所以一次大幅 Elo 提升确实是真实信号,说明在一组混合提示词上人们更偏好它的输出。这是个货真价实的成绩,两个月左右提升 +79 Elo 也确实很快。
但它同时只是一个聚合数字。微软的公告没有公布分类别 Elo、置信区间、提示词集规模,也没说排在它上面的是哪个模型。截至 2026 年 8 月 14 日,一个团队在投入生产管线前需要的若干信息仍未公开:
- 2.6 档位的每张图 API 价格
- 原生分辨率与最大输出分辨率
- 生成与编辑的延迟数据
- 被描述为"即将到来"的多参考图与接地能力
- 支撑那些 Elo 增幅的技术报告
说明
一个总榜名次没法告诉你某个模型是否适合你手上的活。非拉丁文字的重文字包装、要在十二个镜头里保持一致的一张脸、给游戏 UI 用的透明素材,是三种不同的测试,而一个模型完全可能在总分领先的同时输掉其中任何一项。
对 2.6 的诚实读法很窄,但依然有用:微软在快速迭代这个家族,并且把增益瞄准了商业产出——文字、人像、产品、品牌——而不是奇观。
在 OmniArt 上跑这四种模式#
OmniArt 的图片工作台目前没有 MAI-Image。但这些提示词模式有,而且与模型无关。按你手上的活到底属于四件事里的哪一件来挑:
| 模式 | 用途 | OmniArt 上的起点 |
|---|---|---|
| 长结构化提示词 | 服装、道具、颜色和数量会被逐项核对的需求 | GPT Image 2 |
| 带比喻的短堆叠提示词 | 电影感单图与调性探索 | Seedream 5.0 Pro |
| 一次一改的编辑 | 产品配色、增加元素、可控换景 | Nano Banana 2 |
| 引用式速写加显式身份描述 | 需要主体保持一致的场景搭建 | Seedream 5.0 Pro 配合参考图 |
| 定稿前的低成本迭代 | 低价测试提示词结构 | Qwen Image |
一个有用的练习:把上面那条天台提示词原样跑一次,再把颜色换成形容词("a pink bottle""a green wand")、把数量换成"some bubbles",跑第二次。两张成图之间的差距,就是结构的价值——而且是在你自己的模型上量出来的,不是在发布页的图库里。
想看版式与写实度的最新对比,可以读GPT Image 2 与 Nano Banana 2 对比。想了解参考图驱动的一致性,Seedream 5.0 Pro 发布解析讲了它的输入与控制面,而 Qwen Image 指南是早期草图的低成本路线。想读一篇同类的近期发布解析,Grok Imagine Image 2.0 在同一周给出了类似的 Arena 说法。
常见问题#
MAI-Image-2.6 是什么?
MAI-Image-2.6 是微软 AI 于 2026 年 8 月 10 日发布的文生图模型。微软称它在 Arena 文生图榜单上排名第二,整体较 MAI-Image-2.5 提升 +79 Elo,其中文字渲染提升 +91 Elo。
MAI-Image-2.6 与 MAI-Image-2.5 有什么不同?
微软称它在所有被测 Arena 类别上都有提升,并特别强调文字渲染、人像与 3D,以及产品、品牌和电影感方向上更完整的商业与写实输出。多参考图输入、更丰富的接地,以及对推理、格式和分辨率的更强控制被描述为"即将到来",暂无公开细节。
在哪里可以用 MAI-Image-2.6?
微软的公告称它已在 Arena 上提供文生图能力,当周晚些时候上线 MAI Playground,随后逐步覆盖 Microsoft Foundry 和其他产品。
OmniArt 上有 MAI-Image 吗?
没有。OmniArt 的图片模型列表里没有 MAI-Image。本文中的提示词模式与模型无关,可以在 OmniArt 提供的图片模型上使用。
MAI-Image-2.5 家族包含哪些?
三档:MAI-Image-2.5-Pro 面向物体一致性与视觉推理,MAI-Image-2.5 面向高质量生成与可控编辑,MAI-Image-2.5-Flash 被描述为价格不到旗舰一半、可直接投产。
这些提示词模式在别的模型上也有效吗?
有效。颜色名、明确数量、独立圈起来的背景区块、尺度参照物、一次一改的编辑,以及一个撑起构图的比喻,都是通用的提示词技巧。模型之间的差别在于每一条被遵守得有多稳,这值得在你实际用的模型上测一遍。
在 OmniArt 上开始#
打开 OmniArt 图片工作台,把同一个需求用上面四种模式里的两种各跑一遍——同一个想法的长结构化版本和短堆叠版本。主体保持不变,只改提示词的形式。这一次对比告诉你的东西,会比任何榜单名次都多。
接下来把编辑当成单独的一段工作:先定下一张图,然后一条提示词只改一件事,每一轮之后复查你在意的细节。OmniArt 把图片、视频、音频和音乐模型放在同一个工作台里,定稿的静态图可以直接进入动态环节而不用换工具——等到有新模型值得进入列表时,你已经练出来的提示词写法会跟着一起过去。