Come scrivere prompt per Seedance: il metodo Vibe Creating
Impara a scrivere prompt Seedance con un nucleo creativo a quattro livelli e un brief in sette parti per soggetto, azione, ambiente, camera, suono e riferimenti.
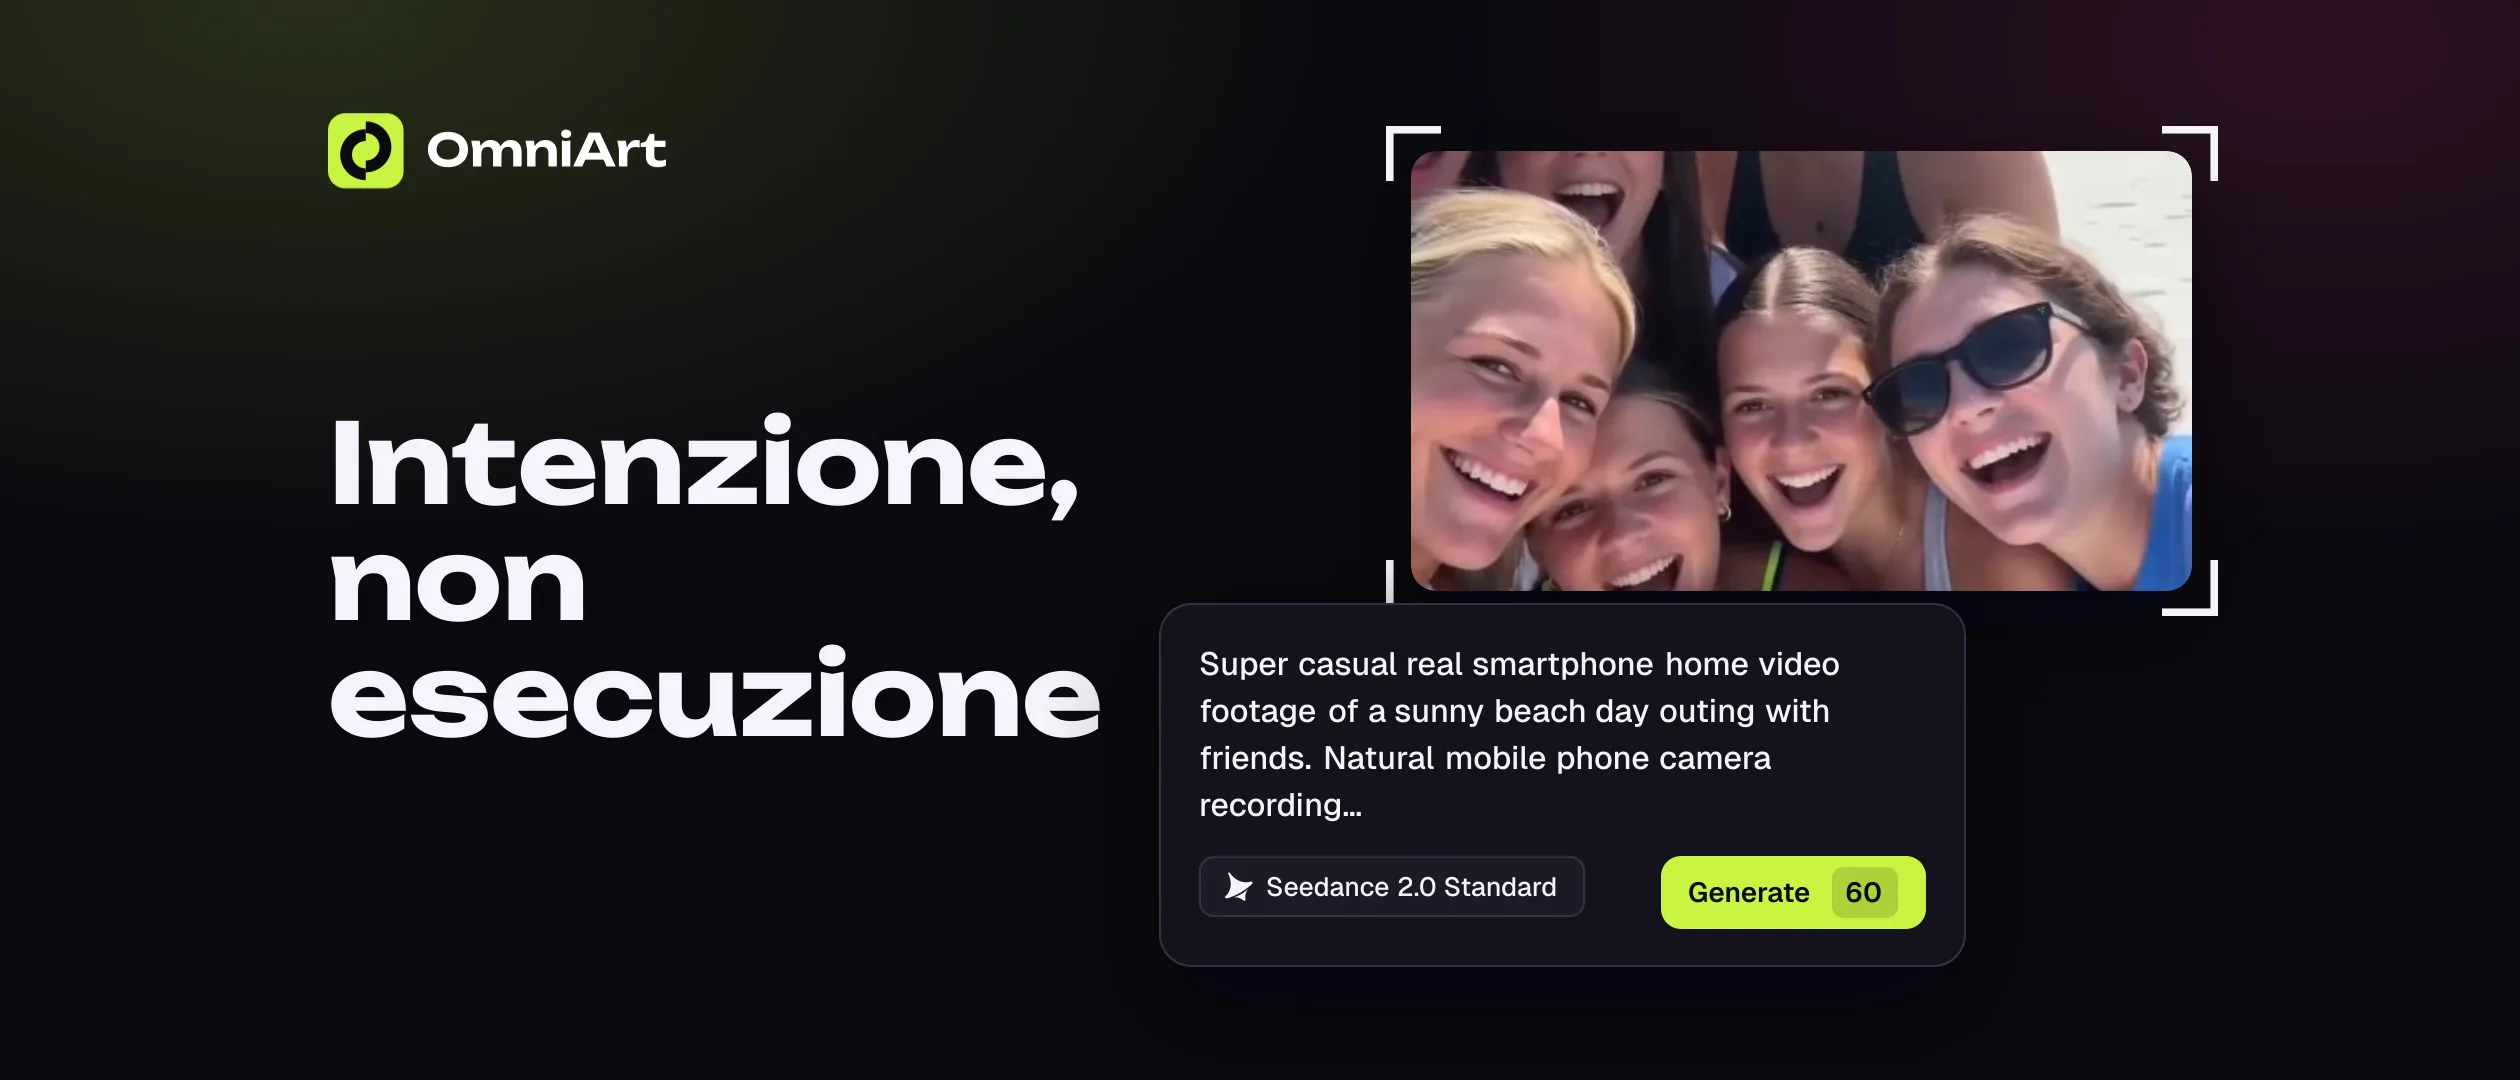
La maggior parte delle persone scrive i prompt per Seedance come se compilasse una scheda tecnica di ripresa: lunghezze focali, movimenti del carrello, numeri di inquadratura, temperature colore. Sembra preciso, ma spesso produce video rigidi e sovra-controllati. Il team di Seedance promuove un approccio diverso che chiamano Vibe Creating — e l'idea centrale è controintuitiva: un modello capace ha bisogno che tu esprima l'intenzione, non che tu microgestisca l'esecuzione.
Questa guida rende il metodo Vibe Creating applicabile già dalla prossima generazione. Imparerai il nucleo creativo a quattro livelli, come ampliarlo in un brief di produzione in sette parti, quale linguaggio di camera eliminare o mantenere e quando il controllo preciso resta la scelta migliore. Seedance 2.0 (Standard e Fast) è disponibile su OmniArt insieme ad altri modelli video, così puoi provare ogni idea mentre leggi.
Nota
I clip di esempio in questo articolo provengono dal manuale pratico «Vibe Creating» di Seedance di ByteDance. Sono qui per illustrare il metodo di prompting — gli stessi principi si trasferiscono su tutti i modelli video diretti di OmniArt, non solo su Seedance.
Cosa significa davvero Vibe Creating#
Vibe Creating è uno spostamento di ruoli: chi fa cosa. La vecchia abitudine tratta il modello come un renderer passivo a cui bisogna specificare ogni parametro. Vibe Creating lo tratta come un collaboratore capace: tu gli consegni la sensazione e l'intenzione, e lasci che sia lui a risolvere i dettagli visivi.
Questo non significa scrivere di meno fine a se stesso, e non significa prompt vaghi. Un prompt come «libertà» o «una sensazione premium» non dà al modello nulla su cui ancorarsi. L'obiettivo è eliminare il rumore tecnico a basso valore e conservare — o aggiungere — le informazioni che fanno davvero reggere un'inquadratura: chi o cosa stiamo guardando, cosa sta succedendo e come dovrebbe sentirsi.
La struttura del prompt a quattro livelli#
La spina dorsale di un prompt Seedance solido è composta da quattro livelli di informazione. Quando una generazione viene fuori piatta o generica, quasi sempre manca uno di questi.
| Livello | Cos'è | Esempio |
|---|---|---|
| Ancora visiva | Il soggetto o elemento più importante | «Un anziano con un cappotto di cotone consumato»; «una strada al neon sotto la pioggia» |
| Azione o stato | Cosa sta facendo, o in quale stato si trova — scegline uno | «si gira lentamente verso la telecamera»; «la pioggia righe il vetro» |
| Tonalità locale | L'atmosfera di questa singola inquadratura, in una o due parole | «controluce ambra caldo»; «un leggero dondolio a mano libera» |
| Tema video | Il caso d'uso più lo stile visivo del pezzo | «un cortometraggio sul distacco»; «una cinematica cyberpunk da videogioco» |
Non devi interrogarti su tutti e quattro ogni volta. Pensa a questa struttura come a una checklist per capire perché un'inquadratura sembra piatta: il più delle volte manca l'ancora visiva o l'azione, e aggiungere solo quel livello risolve il problema.
Ecco la differenza in pratica. Entrambi i prompt qui sotto descrivono la stessa idea — una persona in una carrozza della metropolitana allagata con una balena fuori dal finestrino — ma il secondo riempie i quattro livelli invece di nominare soltanto la scena.
Prompt normale
Vibe Creating
Entrambi sono prompt validi. Ma il secondo fornisce al modello la tonalità (luce blu profonda, immobilità fredda) e un'azione chiara (la balena che scivola oltre), così il risultato porta la sensazione che il creatore stava davvero cercando.
Espandi i quattro livelli in un brief di produzione in sette parti#
I quattro livelli sono il nucleo creativo: definiscono di cosa parla l’inquadratura e come deve essere percepita. Per il passaggio alla produzione, ampliali nei sette campi pratici indicati nella guida di produzione PixVerse di luglio 2026 (Si apre in una nuova scheda): soggetto, azione, ambiente, direzione visiva, direzione della camera, suono e riferimenti. Non è una formula concorrente, ma un modo per rendere esplicita la stessa intenzione quando il prompt deve includere anche materiali, audio e criteri di revisione.
| Campo di produzione | Relazione con Vibe Creating | Cosa scrivere |
|---|---|---|
| Soggetto | Ancora visiva | La persona, il prodotto, la creatura o l’oggetto che il pubblico deve riconoscere |
| Azione | Azione o stato | Il cambiamento principale del clip, preferibilmente come arco d’azione continuo |
| Ambiente | Ancora visiva e tonalità locale | Luogo, momento, meteo e illuminazione che influenzano davvero l’inquadratura |
| Direzione visiva | Tonalità locale e tema del video | Emozione, materiali, palette e stile necessari al contenuto |
| Direzione della camera | Esperienza dello spettatore | Inquadratura o movimento al servizio della storia, espresso con semplicità |
| Suono | Vincolo rigido | Dialogo esatto, ambiente, musica, silenzio o effetti sonori importanti |
| Riferimenti | Prove a supporto del brief | Solo immagini, clip, indicazioni audio o fotogrammi di stile che proteggono il risultato |
Parti dalla frase a quattro livelli e usa i sette campi per individuare le lacune. Se l’ambiente non aggiunge nulla, mantienilo breve. Se non c’è un suono o un riferimento importante, non inventarlo soltanto per completare l’elenco. Un prompt più lungo non è automaticamente migliore.
Per esempio, una rivelazione di prodotto può conservare il nucleo di Vibe Creating rendendo espliciti i materiali di produzione:
Il brief contiene tutti e sette i campi, ma si legge ancora come un’esperienza diretta, non come una pila di impostazioni dell’obiettivo. Quando un modello o flusso di lavoro accetta riferimenti multimodali, inizia con un insieme piccolo e coerente — per esempio un’immagine del prodotto, un fotogramma di stile e un’indicazione ambientale — e aggiungi materiale solo se un test controllato migliora precisione o continuità.
Fidati del modello — dai la giusta quantità di informazioni#
L'errore più comune è il sovra-controllo: accumulare parametri convinti che più istruzioni significhino più fedeltà. In pratica, lasciare spazio al modello produce movimenti più fluidi, transizioni più naturali e un risultato più cinematografico.
Confronta queste due versioni della stessa idea — un bambino in claymation che mette un piede in fallo e cade attraverso un tunnel surreale di mondi. Il primo prompt blocca stile, colore, ottica e cue musicali. Il secondo descrive l'esperienza e lascia che sia il modello a dirigerla.
Prompt normale
Vibe Creating
Una storia più ricca non è la stessa cosa di una pila più lunga di istruzioni. L'esempio successivo mostra che puoi mantenere l'intenzione cinematografica — purché serva la storia invece di dettare l'attrezzatura.
Prompt normale
Vibe Creating
Linguaggio cinematografico: cosa eliminare, cosa tenere#
Il linguaggio cinematografico non è tutto da buttare. Il trucco è separare le istruzioni che dicono al sistema come riprendere dall'intenzione che dice allo spettatore come sentirsi.
Elimina questi — sono controllo tecnico a basso valore che ingabbia il modello:
- Lunghezze focali e valori in millimetri
- Gergo di posizionamento della telecamera e degli accessori, camere A/B, copertura
- Parametri di movimento e moltiplicatori di velocità
- Numeri di inquadratura
- Profondità di campo, diaframma, esposizione, otturatore
- Direttive di montaggio pure
Mantieni e traduci questi elementi — l’intenzione della camera che modella la sensazione e completa il relativo campo del brief di produzione:
- Trasforma «dolly lento in avanti» in «lo sguardo viene attratto più vicino, una silenziosa sensazione di pressione»
- Trasforma «a mano libera» in «un leggero dondolio irrequieto»
- Tieni tutto ciò che dice allo spettatore cosa provare, espresso come risultato invece che come impostazione
L'obiettivo non è eliminare tutto il linguaggio di movimento — è esprimerlo come un'esperienza che il modello può interpretare, non come un numero che deve obbedire.
Mantieni i tuoi vincoli rigidi#
Vibe Creating riscrive i visivi, mai le cose che specifichi esplicitamente. Dialoghi, narrazione, testi di canzoni, cue musicali ed effetti sonori sono vincoli rigidi. Se li hai scritti, tienili tali e quali — riordinali se necessario, ma non lasciare che l'«ottimizzazione» del prompt li parafrasi o li elimini.
Un metodo pratico: quando immagine e suono sono mescolati in un solo prompt, riscrivi liberamente la descrizione visiva, ma sposta le battute esatte e le indicazioni audio nel campo del suono e conservale parola per parola.
Quando non usare Vibe Creating#
Vibe Creating è più efficace per atmosfera, emozione, senso narrativo e associazione visiva. È lo strumento sbagliato quando il lavoro ha uno standard di consegna rigido. Ricorri al controllo preciso a livello di parametri quando hai bisogno di:
- Sincronizzazione labiale esatta, parola per parola, su un lungo pezzo di dialogo
- Presentazioni di funzionalità, demo di interfacce o video istruttivi passo dopo passo
- Consegna industriale su una lista inquadrature fissa e parametri bloccati
In quei casi, la precisione è il punto. Usa Vibe Creating per le inquadrature dove la sensazione conta più delle specifiche, e cambia modalità deliberatamente per il resto.
Facoltativo: perfeziona il prompt con la skill ufficiale di Seedance 2.5#
La guida ufficiale consiglia sd25-pe come passaggio facoltativo di revisione. Installala nel progetto locale e inserisci /sd25-pe seguito dalla bozza nella conversazione con l’IA. Controlla il risultato: conserva dialoghi e indicazioni audio e verifica ogni associazione delle risorse.
npx --yes skills@latest add \
  "https://arkdocs.tos-cn-beijing.volces.com/skills/" \
  --skill sd25-pe \
  --yes
Inizia su OmniArt#
Puoi mettere tutto questo in pratica adesso. Seedance 2.0 — in entrambe le varianti standard e fast — è disponibile nello spazio di creazione video di OmniArt, insieme ad altri modelli video diretti a cui puoi applicare lo stesso metodo.
Un modo semplice per iniziare:
- Scrivi prima la tua ancora visiva e una azione — sono la struttura portante dell’inquadratura.
- Aggiungi una parola di tonalità e un tema affinché il modello comprenda stile e utilizzo.
- Espandi il nucleo nei sette campi: soggetto, azione, ambiente, direzione visiva, direzione della camera, suono e riferimenti.
- Elimina campi o dettagli che non cambiano l’inquadratura. Traduci la meccanica della camera in come il movimento dovrebbe essere percepito.
- Mantieni dialoghi, narrazione e indicazioni musicali esattamente come sono scritti e allega solo riferimenti che proteggono il risultato.
- Genera due o tre varianti con lo stesso pacchetto di prompt, quindi valuta soggetto, azione, camera, suono, continuità e interventi necessari prima di rivederlo.
Se segui l’evoluzione del video AI diretto, la nostra guida allo stato di Seedance 2.5 distingue le capacità annunciate di generazione più lunga e con più riferimenti dalla disponibilità verificata. Apri lo spazio di lavoro, scrivi quattro livelli sinceri, amplia solo ciò che serve al brief di produzione e confronta i risultati con un criterio coerente.