Seedance
学习如何写 Seedance 提示词:用四层创意核心与七部分制作简报,明确主体、动作、场景、镜头、声音和参考素材,并建立可重复的 AI 视频测试与制作流程
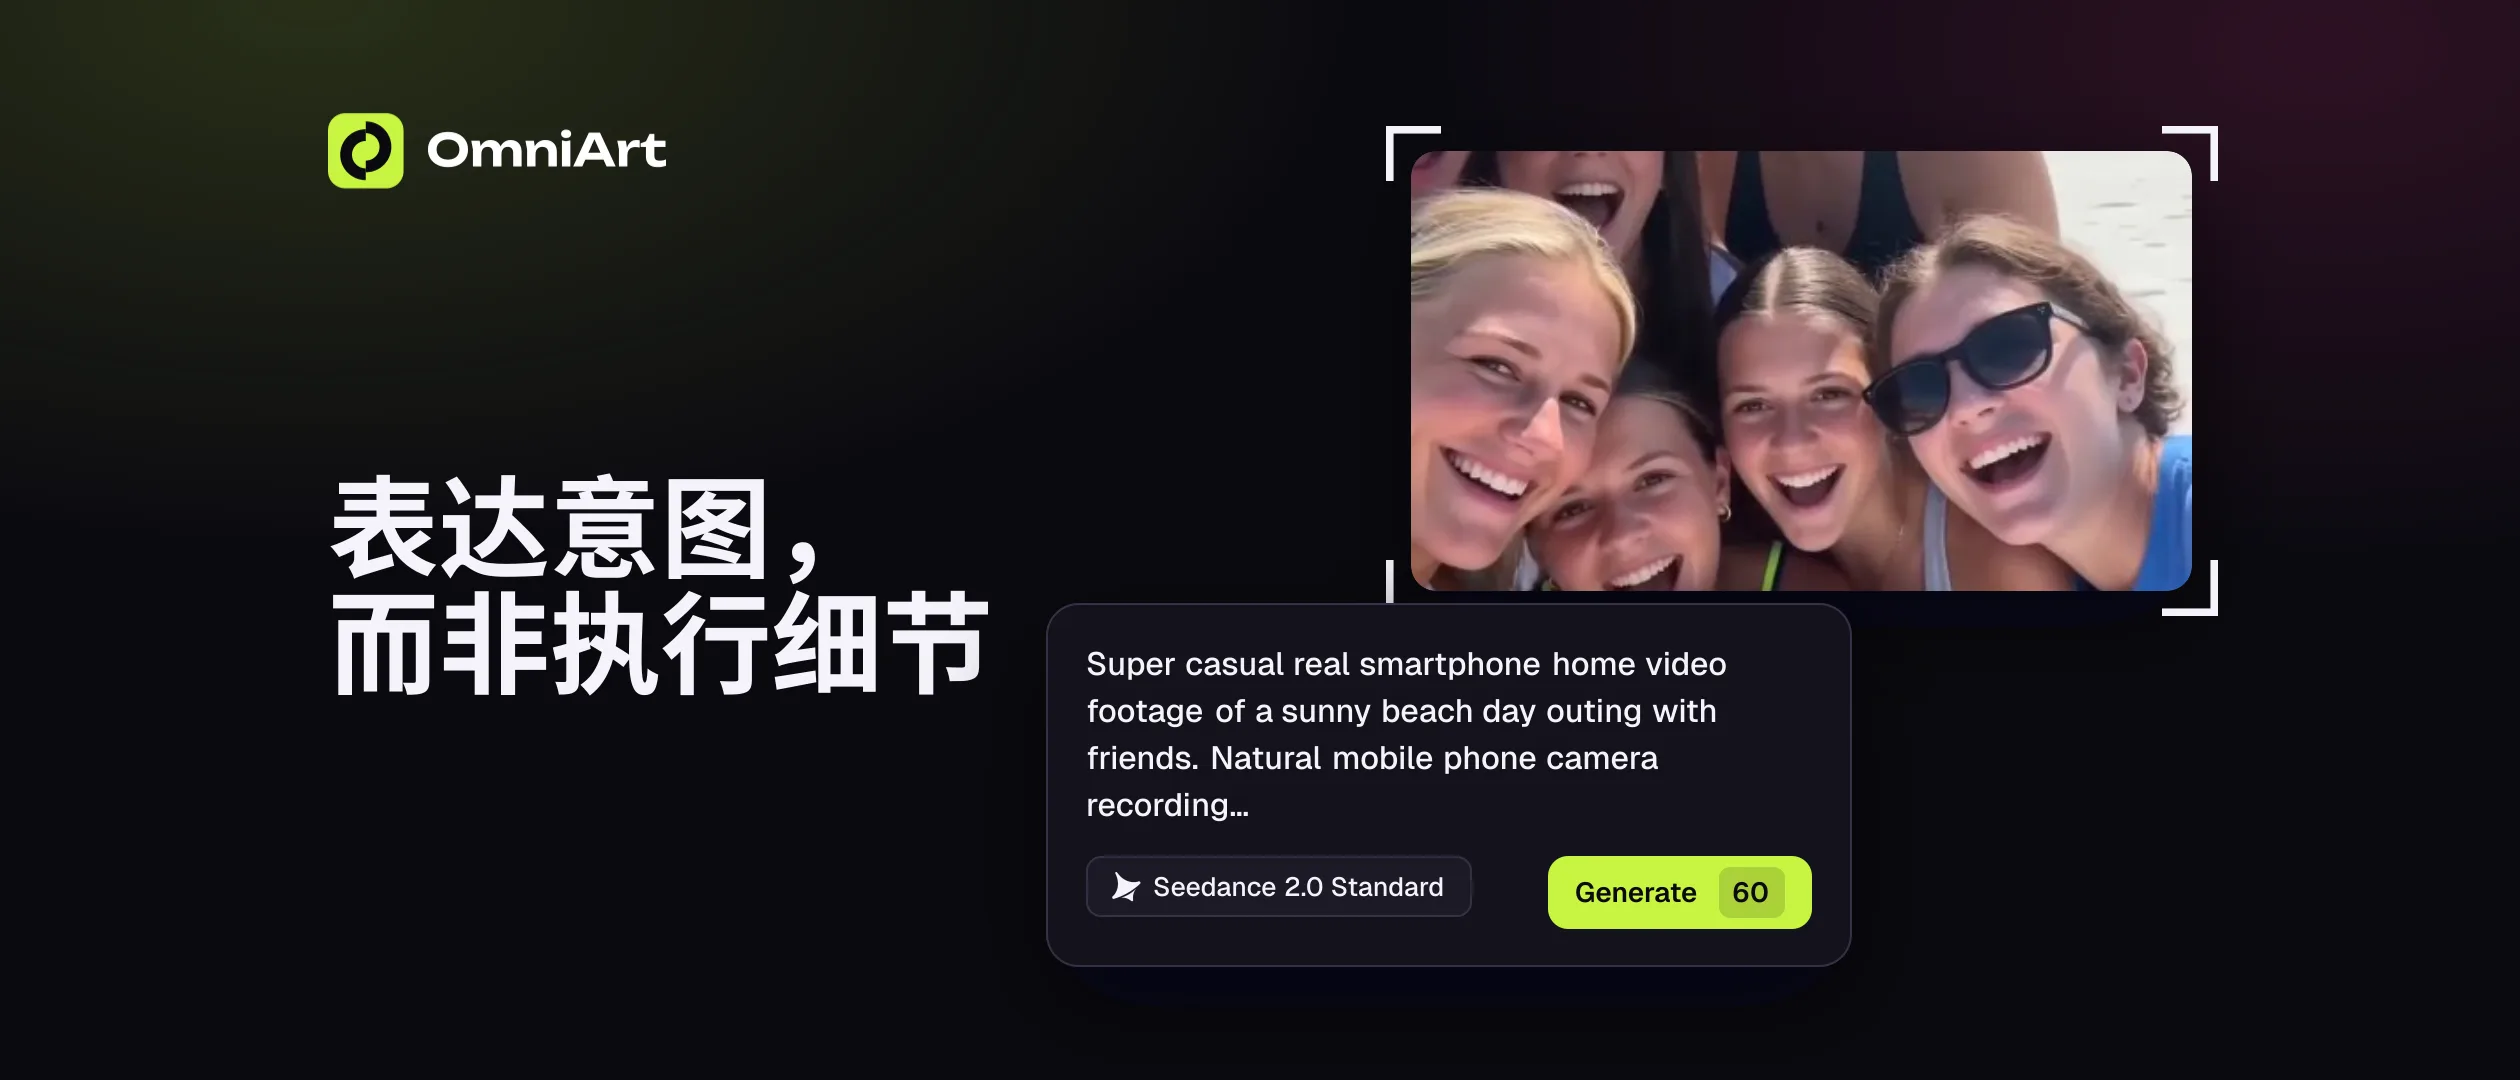
大多数人写 Seedance 提示词的方式,就像在写摄影报告:焦段、云台运动、镜号、色温。看起来很精确,但往往生成的视频僵硬、过度雕琢。Seedance 团队一直在推广一种叫做 Vibe Creating 的新思路——核心理念有些反直觉:一个有能力的模型需要你传达意图,而不是事无巨细地指定执行方式。
这篇教程会把 Vibe Creating 方法拆成你下次生成就能使用的步骤。你将学会四层创意核心、如何把它扩展为七部分制作简报、哪些镜头语言该删或保留,以及哪些场景仍然需要精确控制。Seedance 2.0(标准版和快速版)已在 OmniArt 与其他视频模型一同上线,你可以边读边测试每个想法。
说明
本文的示例片段来自字节跳动 Seedance「Vibe Creating」实践手册,用于说明提示词方法。同样的原则适用于 OmniArt 上所有导演式视频模型,并不局限于 Seedance。
Vibe Creating 究竟是什么#
Vibe Creating 是一种分工方式的转变。旧习惯把模型当成需要把每个参数都写清楚的「哑渲染器」。Vibe Creating 则把它当成有能力的合作者:你交出感觉和意图,让模型来解决视觉细节。
这不是说提示词写得越少越好,也不是说写得含糊就行。「自由感」或「高端质感」这类描述给不了模型任何抓手。目标是删掉低价值的技术噪音,保留(或补充)真正能撑起一个镜头的信息:画面里有谁或有什么、正在发生什么、应该有什么感觉。
四层提示词结构#
一个强力的 Seedance 提示词由四层信息构成。当生成结果单薄或流于普通时,几乎总是因为缺少其中某一层。
| 层级 | 是什么 | 示例 |
|---|---|---|
| 视觉锚点 | 最重要的单一主体或元素 | 「穿着旧棉衣的老人」;「雨中霓虹街道」 |
| 动作或状态 | 它在做什么,或它处于什么状态——选一个 | 「缓缓转向镜头」;「雨水顺着玻璃流淌」 |
| 局部氛围 | 这个镜头的感觉,用一两个词点出 | 「暖琥珀色逆光」;「轻微的手持晃动感」 |
| 视频主题 | 使用场景加上这支片的视觉风格 | 「一部关于离别的短片」;「赛博朋克游戏宣传片」 |
你不必每次都逐层审问自己。把它当成一张「镜头为什么感觉平」的排查清单:最常见的情况是视觉锚点或动作缺失,补上那一层往往就够了。
下面这两条提示词描述的是同一个创意——地铁车厢被海水淹没、窗外有鲸鱼游过——但第二条填入了四层信息,而不只是描述场景。
普通提示词
Vibe Creating
两条提示词本身都成立,但第二条给了模型氛围(深蓝色水下光、冰冷的静止感)和清晰的动作(鲸鱼缓缓划过),所以结果真正承载了创作者想要的感觉。
把四层扩展为七部分制作简报#
四层是创意核心:它们定义镜头讲什么、应该带来什么感受。交付制作时,可以按照 PixVerse 2026 年 7 月制作指南 (在新标签页中打开)把核心扩展为七个实用字段:主体、动作、场景、视觉方向、镜头方向、声音和参考素材。这不是另一套相互竞争的公式,而是在提示词还要包含素材、音频和审核标准时,把同一意图表达得更明确。
| 制作字段 | 与 Vibe Creating 的对应关系 | 应该写什么 |
|---|---|---|
| 主体 | 视觉锚点 | 观众必须认出的一个人、产品、生物或物体 |
| 动作 | 动作或状态 | 片段中的主要变化,最好是一条连贯的动作弧线 |
| 场景 | 视觉锚点加局部氛围 | 真正影响镜头的地点、时间、天气和光线 |
| 视觉方向 | 局部氛围加视频主题 | 作品所需的情绪、材质、色彩和风格 |
| 镜头方向 | 观看体验 | 为叙事服务的构图或运动,用简单语言表达 |
| 声音 | 硬性约束 | 重要的准确台词、环境声、音乐、静默或音效 |
| 参考素材 | 制作简报的依据 | 只放真正能保护结果的图片、片段、音频提示或风格帧 |
先写四层句子,再用七个字段检查缺口。如果场景没有增加信息,就简短带过;如果没有重要的声音或参考素材,也不要为了凑齐清单而编造。提示词更长并不自动意味着更好。
例如,产品揭晓可以保留 Vibe Creating 的核心,同时明确制作输入:
这份简报包含全部七个字段,但读起来仍是一段有明确导演意图的体验,而不是一叠镜头参数。模型或工作流支持多模态参考时,先用一组小而一致的素材——例如一张产品图、一张风格帧和一项环境提示——只有在受控测试确实改善准确性或连续性时才增加素材。
信任模型——给出恰当的信息量#
最常见的错误是过度控制:不断堆叠参数,以为指令越多就越精确。实际上,给模型留出余地,才能得到更流畅的运动、更自然的转场和更有电影感的结果。
对比下面两种对同一创意的处理方式——一个定格动画风格的小男孩踩空、坠入充满奇幻世界的隧道。第一条提示词锁定了风格、色彩、镜头和音乐提示;第二条描述体验,让模型来导演。
普通提示词
Vibe Creating
更丰富的故事并不等于更长的指令列表。下一个例子说明,摄影机意图是可以保留的——只要它服务于故事,而不是在规定器材。
普通提示词
Vibe Creating
摄影语言:哪些该删,哪些该留#
摄影语言并非一无是处。关键在于区分「告诉系统怎么拍」的指令,和「告诉观众怎么感受」的意图。
删掉这些——它们是低价值的技术控制,会把模型框死:
- 焦距和毫米数值
- 机位与摄影器材术语、A/B 机、角度覆盖
- 运动参数和速度倍率
- 镜号
- 景深、光圈、曝光、快门
- 纯剪辑指令
保留并转化这些——塑造感受、同时补齐制作简报中镜头方向字段的镜头意图:
- 把「慢推近」转化为「视线被缓缓吸引,带来一种轻微的压迫感」
- 把「手持」转化为「轻微的、不安的晃动感」
- 凡是能告诉观众该有什么感受的表达,都用结果来描述,而不是用数值来规定
重点不是抹掉所有运动语言,而是把它表达成模型能够诠释的体验,而不是它必须照单全收的数字。
保留你的硬性约束#
Vibe Creating 改写的是视觉描述,绝不动你明确指定的内容。台词、旁白、歌词、音乐提示、音效都是硬性约束。如果你已经写好了,就原文保留——顺序可以调整,但不要让「优化提示词」的过程改写或删掉它们。
一个实用方法:当画面和声音混在同一条提示词里时,可以自由改写视觉描述,但要把准确台词和音频提示提取到声音字段中,并逐字保留。
什么时候不适合用 Vibe Creating#
Vibe Creating 最适合处理氛围、情感、叙事感觉和视觉联想。当任务有严格的交付标准时,它就不是合适的工具了。以下情况请用精确的参数级控制:
- 长段对话的逐字口型同步
- 功能演示、UI 展示,或分步骤的教学视频
- 有固定分镜表和锁定参数的工业化交付
在这些场景里,精确本身就是目的。把 Vibe Creating 用在感觉比规格更重要的镜头上,其余的情况则有意识地切换模式。
可选:使用官方 Seedance 2.5 skill 调优#
官方使用指南推荐把 sd25-pe 作为可选的提示词调优步骤。在本地项目中安装后,在 AI 对话中输入 /sd25-pe 加上草稿提示词。调优结果仍需人工核对:保留原始对白和声音指令,并逐项确认素材映射。
npx --yes skills@latest add \
  "https://arkdocs.tos-cn-beijing.volces.com/skills/" \
  --skill sd25-pe \
  --yes
在 OmniArt 上开始实践#
你现在就可以动手了。Seedance 2.0 的标准版和快速版都已上线 OmniArt 的视频创作工作台,你可以把同样的方法用在其他导演式视频模型上。
一个简单的起步方式:
- 先写视觉锚点和一个动作——这是镜头的骨架。
- 加一个氛围词和一个主题,让模型理解风格与用途。
- 把核心扩展为七部分简报:主体、动作、场景、视觉方向、镜头方向、声音和参考素材。
- 删除不会改变镜头的字段或细节,把镜头机械参数转化为运动应该带来的感受。
- 台词、旁白和音乐提示保持原文不变,只附上真正能保护结果的参考素材。
- 用同一套提示词和素材运行两到三个版本,在修改前按主体、动作、镜头、声音、连续性和清理工作量评分。
如果你在关注导演式 AI 视频的发展,可以阅读我们的 Seedance 2.5 发布状态指南:它把已公布的长时生成和多参考能力与已经验证的可用性分开说明。打开工作台,先诚实地写出四层信息,只在制作简报确有需要时扩展,并用同一套标准比较结果。